Whisper
- 추천0
- GitHub 별113K
- 음성·오디오라이선스MIT
OpenAI의 범용 음성 인식 모델. 다국어 받아쓰기 · 영어 번역 · 언어 감지를 하나의 모델로 해요(Python · CLI). MIT
요약
OpenAI의 범용 음성 인식 모델. 다국어 받아쓰기 · 영어 번역 · 언어 감지를 하나의 모델로 해요(Python · CLI). MIT
설명
Whisper
Whisper는 범용 음성 인식 모델입니다. 다양한 오디오로 이루어진 대규모 데이터셋으로 학습했고, 다국어 음성 인식, 음성 번역, 언어 식별까지 해내는 멀티태스킹 모델이기도 합니다.
접근 방식
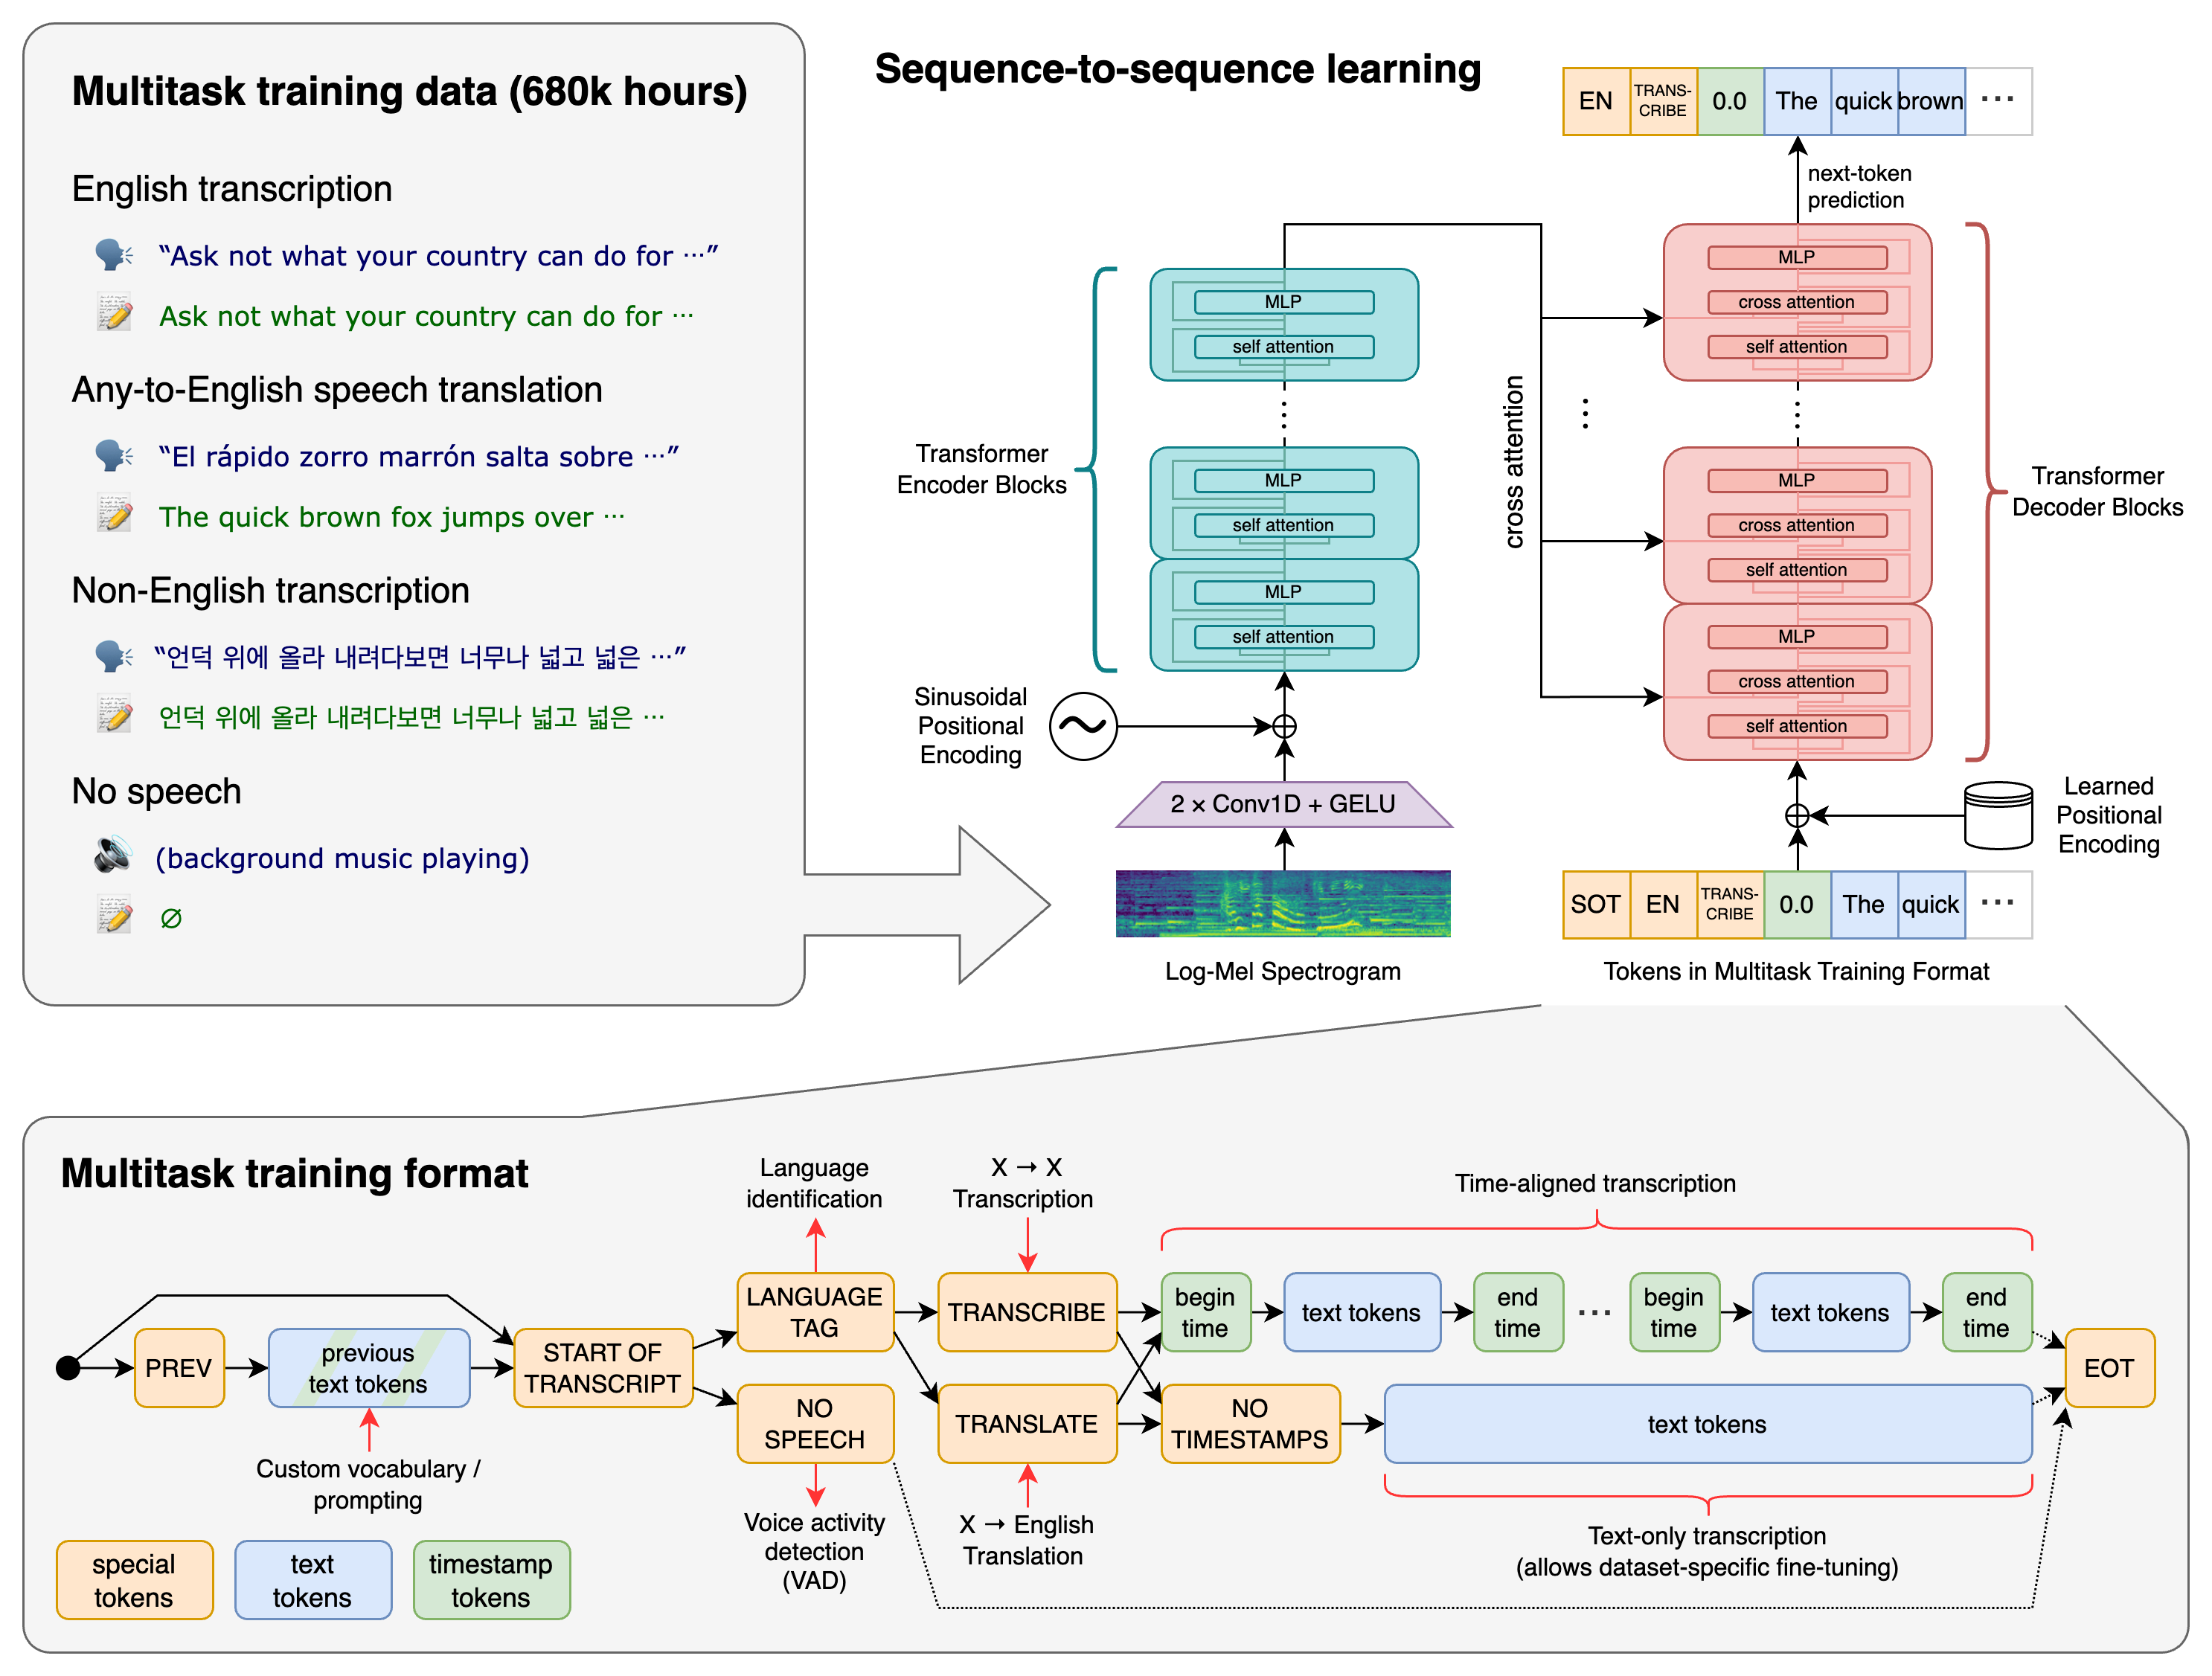
Transformer 시퀀스-투-시퀀스 모델을 여러 음성 처리 작업(다국어 음성 인식, 음성 번역, 음성 언어 식별, 음성 구간 검출)으로 학습했습니다. 이 작업들은 디코더가 예측할 토큰 열 하나로 함께 표현되므로, 모델 하나가 전통적인 음성 처리 파이프라인의 여러 단계를 대신할 수 있습니다. 멀티태스크 학습 형식은 작업 지정자 또는 분류 대상 역할을 하는 특수 토큰 묶음을 사용합니다.
설치
저자들은 Python 3.9.9와 PyTorch 1.10.1로 모델을 학습하고 시험했지만, 코드는 Python 3.8~3.11과 최신 PyTorch 버전에서도 호환될 것으로 기대합니다. 이 코드는 몇 가지 Python 패키지에 의존하며, 그중에서도 빠른 토크나이저 구현을 위해 OpenAI의 tiktoken이 가장 중요합니다. 아래 명령으로 Whisper 최신 릴리스를 설치(또는 업데이트)할 수 있습니다.
pip install -U openai-whisper
또는 아래 명령으로 이 저장소의 최신 커밋과 그 Python 의존성을 설치할 수도 있습니다.
pip install git+https://github.com/openai/whisper.git
이 저장소의 최신 버전으로 패키지를 업데이트하려면 다음을 실행하세요.
pip install --upgrade --no-deps --force-reinstall git+https://github.com/openai/whisper.git
시스템에 명령줄 도구 ffmpeg도 설치되어 있어야 합니다. 대부분의 패키지 관리자로 설치할 수 있습니다.
# Ubuntu 또는 Debian
sudo apt update && sudo apt install ffmpeg

# Arch Linux
sudo pacman -S ffmpeg

# macOS(Homebrew 사용, https://brew.sh/)
brew install ffmpeg

# Windows(Chocolatey 사용, https://chocolatey.org/)
choco install ffmpeg

# Windows(Scoop 사용, https://scoop.sh/)
scoop install ffmpegtiktoken이 사용 중인 플랫폼용으로 미리 빌드된 휠을 제공하지 않으면 rust도 설치해야 할 수 있습니다. 위 pip install 중에 설치 오류가 나면 시작하기 페이지를 따라 Rust 개발 환경을 설치하세요. 또한 PATH 환경 변수를 설정해야 할 수도 있습니다. 예: export PATH="$HOME/.cargo/bin:$PATH". No module named 'setuptools_rust' 오류와 함께 설치가 실패하면 setuptools_rust를 설치해야 합니다. 예를 들면 다음과 같습니다.
pip install setuptools-rust사용할 수 있는 모델과 언어
모델 크기는 여섯 가지이고, 그중 네 가지는 영어 전용 버전이 있어 속도와 정확도 사이에서 고를 수 있습니다. 아래는 사용할 수 있는 모델 이름과 대략적인 메모리 요구량, 그리고 large 모델 대비 추론 속도입니다. 상대 속도는 A100에서 영어 음성을 받아쓴 결과이며, 실제 속도는 언어, 말하는 속도, 사용 가능한 하드웨어 등 여러 요인에 따라 크게 달라질 수 있습니다.
| 크기 | 파라미터 | 영어 전용 모델 | 다국어 모델 | 필요 VRAM | 상대 속도 |
|---|---|---|---|---|---|
| tiny | 39 M | tiny.en | tiny | ~1 GB | ~10x |
| base | 74 M | base.en | base | ~1 GB | ~7x |
| small | 244 M | small.en | small | ~2 GB | ~4x |
| medium | 769 M | medium.en | medium | ~5 GB | ~2x |
| large | 1550 M | 해당 없음 | large | ~10 GB | 1x |
| turbo | 809 M | 해당 없음 | turbo | ~6 GB | ~8x |
영어 전용 애플리케이션에는 .en 모델이 더 잘 동작하는 경향이 있고, 특히 tiny.en과 base.en에서 두드러집니다. small.en과 medium.en에서는 그 차이가 덜해지는 것으로 관찰되었습니다.
또한 turbo 모델은 large-v3를 최적화한 버전으로, 정확도 저하를 최소화하면서 더 빠르게 받아쓸 수 있습니다.
Whisper의 성능은 언어에 따라 크게 다릅니다. 아래 그림은 Common Voice 15와 Fleurs 데이터셋으로 평가한 large-v3와 large-v2 모델의 언어별 WER(단어 오류율) 또는 CER(문자 오류율, 기울임으로 표시) 분석입니다. 다른 모델과 데이터셋에 해당하는 WER/CER 지표는 논문의 부록 D.1, D.2, D.4에, 번역에 대한 BLEU(Bilingual Evaluation Understudy) 점수는 부록 D.3에 있습니다.
명령줄 사용법
아래 명령은 turbo 모델로 오디오 파일의 음성을 받아씁니다.
whisper audio.flac audio.mp3 audio.wav --model turbo기본 설정(turbo 모델 선택)은 영어를 받아쓸 때 잘 동작합니다. 다만 turbo 모델은 번역 작업용으로 학습되지 않았습니다. 영어가 아닌 음성을 영어로 번역해야 한다면 turbo 대신 다국어 모델(tiny, base, small, medium, large) 중 하나를 쓰세요.
예를 들어 영어가 아닌 음성이 담긴 오디오 파일을 받아쓰려면 언어를 지정할 수 있습니다.
whisper japanese.wav --language Japanese음성을 영어로 번역하려면 다음과 같이 합니다.
whisper japanese.wav --model medium --language Japanese --task translate참고:
--task translate를 지정해도turbo모델은 원래 언어로 결과를 돌려줍니다. 가장 좋은 번역 결과를 얻으려면medium이나large를 쓰세요.
사용할 수 있는 모든 옵션을 보려면 다음을 실행하세요.
whisper --help사용할 수 있는 모든 언어 목록은 tokenizer.py를 보세요.
Python 사용법
Python 안에서도 받아쓰기를 할 수 있습니다.
import whisper

model = whisper.load_model("turbo")
result = model.transcribe("audio.mp3")
print(result["text"])
내부적으로 transcribe() 메서드는 파일 전체를 읽고, 30초 길이의 슬라이딩 윈도로 오디오를 처리하면서 각 윈도에서 자기회귀 시퀀스-투-시퀀스 예측을 수행합니다.
아래는 더 낮은 수준의 접근을 제공하는 whisper.detect_language()와 whisper.decode()의 사용 예입니다.
import whisper

model = whisper.load_model("turbo")

# 오디오를 불러와 30초에 맞게 채우거나 자릅니다
audio = whisper.load_audio("audio.mp3")
audio = whisper.pad_or_trim(audio)

# 로그 멜 스펙트로그램을 만들어 모델과 같은 장치로 옮깁니다
mel = whisper.log_mel_spectrogram(audio, n_mels=model.dims.n_mels).to(model.device)

# 말한 언어를 감지합니다
_, probs = model.detect_language(mel)
print(f"Detected language: {max(probs, key=probs.get)}")

# 오디오를 디코딩합니다
options = whisper.DecodingOptions()
result = whisper.decode(model, mel, options)

# 인식된 글을 출력합니다
print(result.text)
더 많은 예제
웹 데모, 다른 도구와의 연동, 다른 플랫폼용 이식 같은 Whisper의 다양한 사용 예와 서드파티 확장을 공유하려면 Discussions의 🙌 Show and tell 카테고리를 이용해 주세요.
라이선스
Whisper의 코드와 모델 가중치는 MIT 라이선스로 공개되어 있습니다. 자세한 내용은 LICENSE를 보세요.
저장소: openai/whisper
평점
- 5점
- 0
- 4점
- 0
- 3점
- 0
- 2점
- 0
- 1점
- 0