FinanceToolkit
- 추천0
- GitHub 별5.5K
- 금융라이선스MIT
재무제표 · 비율 · 위험 지표 500개+를 계산 방식이 투명하게 공개된 코드로 제공하는 재무 분석 툴킷(MCP 서버도 지원)
요약
재무제표 · 비율 · 위험 지표 500개+를 계산 방식이 투명하게 공개된 코드로 제공하는 재무 분석 툴킷(MCP 서버도 지원)
설명
FinanceToolkit



여러 웹사이트를 둘러보다 보면 같은 재무 지표가 출처마다 크게 다르게 나오는 것을 자주 보았습니다. 마찬가지로 보고된 재무제표도 서로 맞지 않는 경우가 많았고, 각 지표를 어떤 방법론으로 계산했는지에 대한 정보는 제한적이었습니다.
예를 들어 2023년 5월 6일 마이크로소프트의 주가수익비율(PER)은 28.93(Stockopedia), 32.05(Morningstar), 32.66(Macrotrends), 33.09(Finance Charts), 33.66(Y Charts), 33.67(월스트리트저널), 33.80(야후 파이낸스), 34.4(Companies Market Cap)로 보고됩니다. 모두 올바른 계산이지만 계산 방법이 달라 결과가 다릅니다. 그래서 여러 출처에서 데이터를 모으면 한 출처가 다른 정의를 쓰는 탓에 결과를 잘못 해석할 수 있습니다. 게다가 그 정의가 공개되어 있기라도 하면 다행이고, 기반 방법은 유료 구독 뒤에 숨겨져 있는 경우가 많습니다.
그래서 FinanceToolkit을 설계했습니다. 관련된 모든 금융 방법(500개 이상)을 가장 단순한 방식으로 적어 계산 방법을 완전히 투명하게(증명) 볼 수 있는 오픈소스 툴킷입니다. 방법을 밝히지 않는 다른 제공자의 지표에 의존하지 않아도 됩니다. 풍부한 재무제표가 손에 있으면 계산이 간소해지고, 일관되고 보편적으로 이해되는 방법과 공식을 쓰도록 돕습니다.
주식 외에도 옵션, 통화, 암호화폐, ETF, 뮤추얼 펀드, 지수, 머니마켓, 원자재, 주요 경제 지표 등을 지원해 과거 데이터와 샤프 지수, 위험가치(VaR) 같은 중요한 성과 · 위험 측정값을 얻을 수 있습니다.
여기에 Finance Database 🌎가 더해집니다. 주식, ETF, 펀드, 지수, 통화, 암호화폐, 머니마켓을 담은 30만 개 이상의 심볼 데이터베이스입니다. 둘을 함께 쓰면 FinanceDatabase에서 찾은 종목을 FinanceToolkit에 넣어 본격적인 경쟁사 분석을 할 수 있습니다.
🔌 Finance Toolkit은 MCP 서버로도 쓸 수 있습니다
Claude, Copilot, Cursor, Windsurf 또는 MCP 호환 클라이언트에서 코드를 쓰지 않고 500개 이상의 메서드를 호출하세요.
- 호스팅:
https://financetoolkit.jeroenbouma.com/mcp에 연결하세요. 처음 쓸 때 OAuth가 나머지를 처리합니다. - 로컬:
uvx --from "financetoolkit[mcp]" financetoolkit-mcp-setup— 클라이언트 설정과 API 키를 자동으로 잡아 줍니다. 수동 설정은 MCP 서버 문서를 보세요.
Smithery, Glama, MCP Servers 등에도 올라 있습니다.
목차
- 설치
- 기능: 섹터 발견하기 · 시장 따라가기 · 경쟁사 들여다보기 · 위험과 수익 따져 보기 · 옵션 시장이 기대하는 것 · 경제 환경 · 경제적 관계 · 섹터의 ETF 비교하기 · 분산 포트폴리오 만들기 · 포트폴리오 따라가기
- MCP 서버
- 질문과 답변
- 기여하기
- 언급
- 문의
설치
설치하기 전에 GitHub에서 프로젝트에 별을 달아 주세요. 다른 사람이 프로젝트를 찾는 데 도움이 됩니다.
Finance Toolkit을 설치하려면 다음만 하면 됩니다.
pip install financetoolkit -U
그런 다음 파이썬에서 다음을 씁니다.
from financetoolkit import Toolkit

companies = Toolkit(
    tickers=['AAPL', 'MSFT'],
    api_key="FINANCIAL_MODELING_PREP_KEY",  # replace with your actual API key
)
시작하려면 FinancialModelingPrep에서 API 키를 받아야 합니다. 30년 이상의 연간 · 분기 재무제표에 접근하는 데 쓰입니다. 무료 플랜은 하루 250회 요청, 5년치 데이터로 제한되고 미국 거래소 상장 기업만 있습니다.
여기서 FinancialModelingPrep API 키를 받으세요.
이 링크로 무료 플랜과 프리미엄 플랜을 15% 할인된 가격에 구독할 수 있습니다. 제휴 링크이며 동시에 프로젝트를 후원합니다. FinancialModelingPrep을 고른 이유는 가장 투명하고 믿을 만하며 부담 없는 가격이라고 보았기 때문입니다. 이만한 데이터를 이렇게 낮은 가격에 제공하는 플랫폼을 아직 찾지 못했습니다. 데이터가 부정확하거나 데이터와 관련한 다른 문제가 있다면, 저는 이 데이터에 접근하는 수단만 제공할 뿐 데이터 자체의 정확성에는 책임이 없다는 점을 알아 두세요. 그럴 때는 그쪽 문의 양식을 쓰거나 데이터를 직접 제공하세요.
기본적으로 Finance Toolkit은 데이터를 가져올 때 Financial Modeling Prep을 우선합니다. Financial Modeling Prep에서 데이터를 못 받으면(예: 요금제 제한이나 API 키 문제) 툴킷이 자동으로 야후 파이낸스를 보조 출처로 바꿉니다. 이 대체 동작을 끄고 Financial Modeling Prep만 쓰려면 Toolkit을 초기화할 때 enforce_source="FinancialModelingPrep"을 설정하세요. 이렇게 하면 Financial Modeling Prep 데이터에 접근하지 못할 때 오류가 납니다. 또는 enforce_source="YahooFinance"로 야후 파이낸스만 데이터 출처로 쓸 수도 있습니다.
같은 enforce_source 인수는 get_historical_data, get_treasury_data와 네 가지 재무제표 함수(get_balance_sheet_statement, get_income_statement, get_cash_flow_statement, get_statistics_statement)에서도 호출마다 받으며, Toolkit을 초기화할 때 정한 값을 덮어씁니다.
기능
이 절은 Finance Toolkit의 소개입니다. 문서에는 더 많은 예시가 있습니다. 모든 모듈 페이지가 기초부터 맞춤 비율 만들기와 내 데이터셋 다루기까지 시작하기 절로 열립니다.
아래 절은 반도체 섹터 분석 하나를 처음부터 끝까지 따라갑니다. 각 단계는 앞 단계가 던진 질문에 답합니다. 섹터를 이루는 기업은 무엇인지, 주가는 어땠는지, 무엇이 이익을 이끄는지, 수익에 얼마나 위험이 따랐는지, 옵션 시장이 다음에 무엇을 기대하는지, 경제가 이 모든 것을 어떻게 빚었는지, 펀드가 더 나은 진입 방법인지, 섹터가 분산 포트폴리오에 어떻게 들어맞는지. Finance Toolkit의 모든 모듈이 한 번씩 나오지만 각각 보여 준 것보다 훨씬 많은 기능을 담고 있습니다. 모두 합쳐 500개 이상의 메서드가 있고 문서에 예시와 함께 설명되어 있습니다.
섹터 발견하기
분석은 기업 묶음에서 시작합니다. Discovery 모듈은 아직 종목 코드가 없어도 주식 스크리너, 섹터 성과, 뉴스, 기업 · ETF · 지수 · 통화 · 암호화폐 · 원자재 목록으로 기업을 찾아 줍니다.
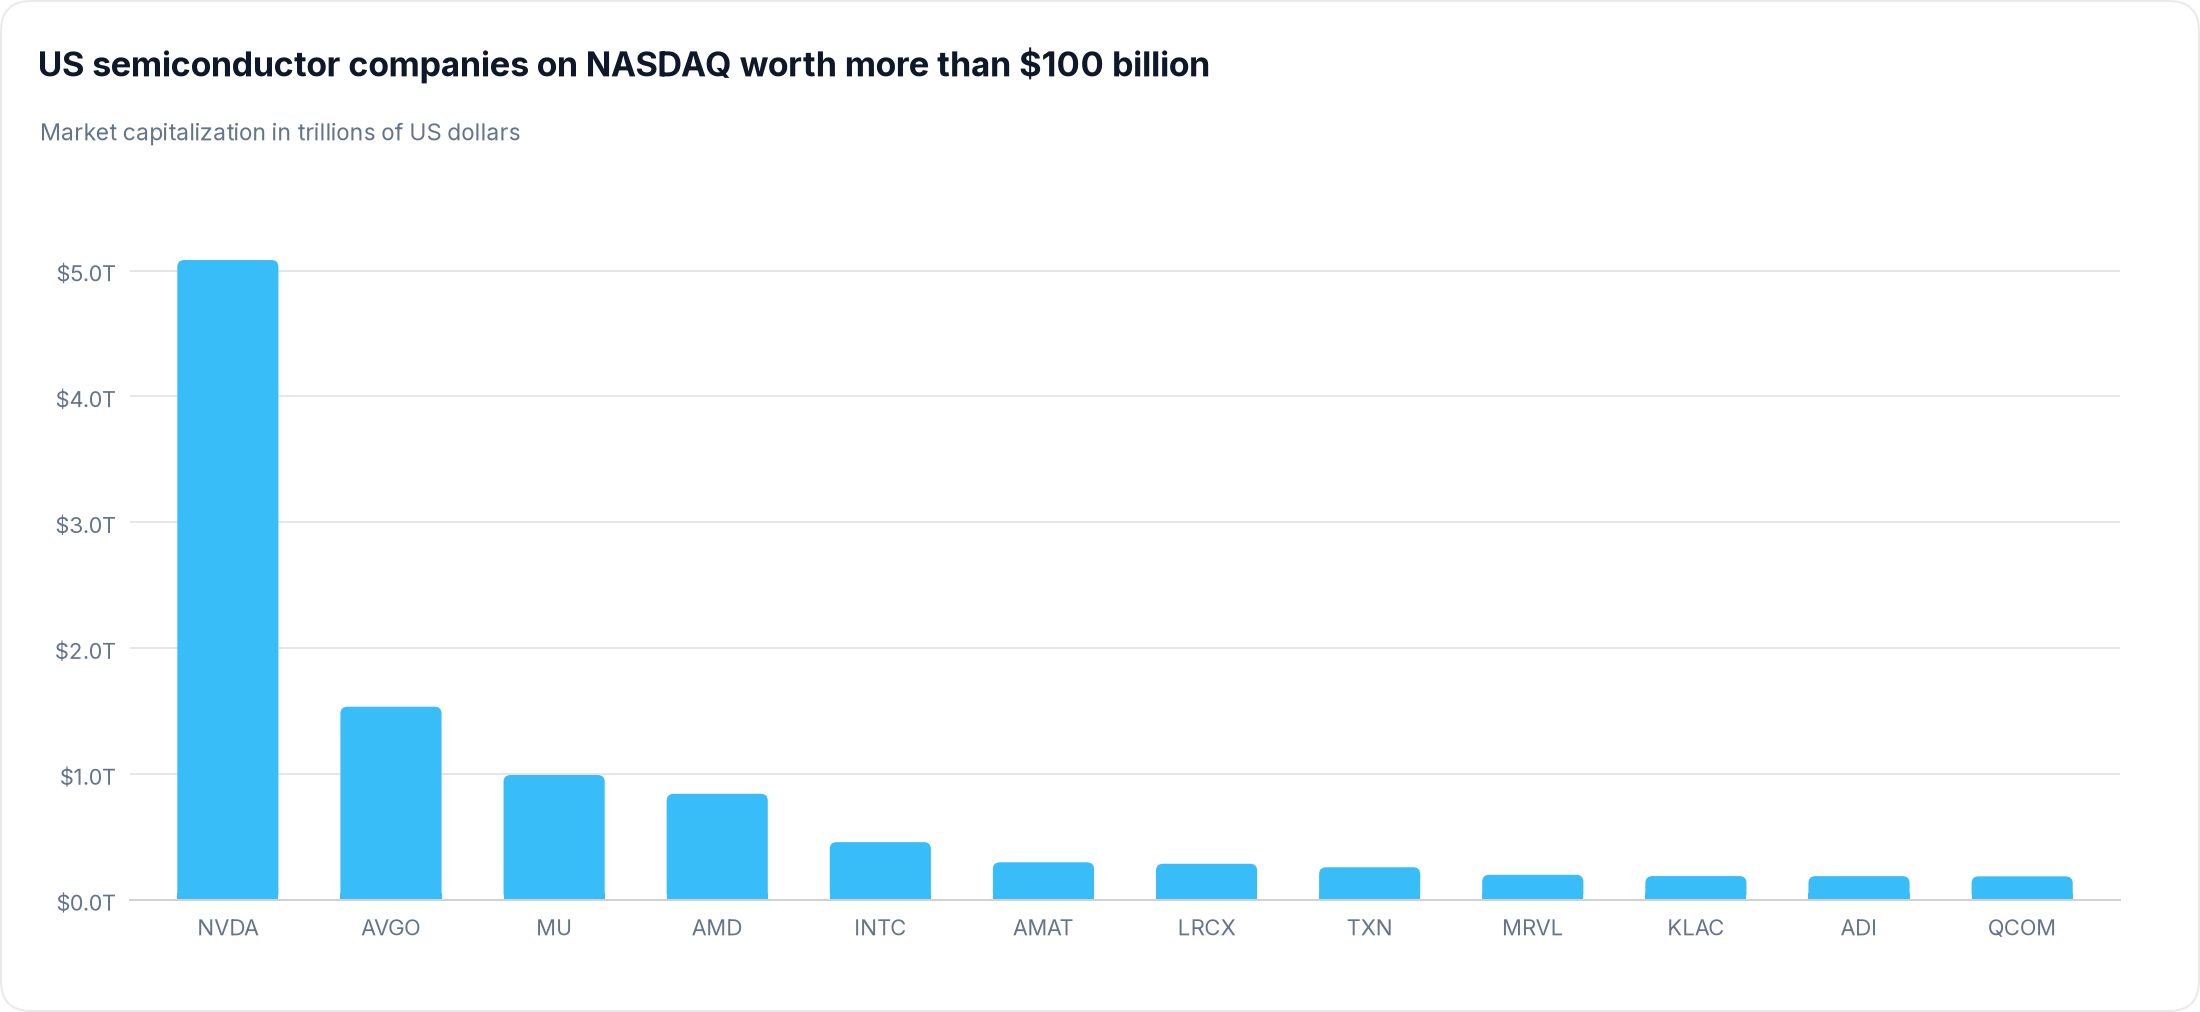
아래 스크리너는 시가총액 1,000억 달러가 넘는 나스닥 반도체 기업을 찾습니다.
from financetoolkit import Discovery

# Initialize the standalone Discovery module
discovery = Discovery(api_key="FINANCIAL_MODELING_PREP_KEY")

# Find US semiconductor companies worth more than $100 billion
semiconductors = discovery.get_stock_screener(
    industry="Semiconductors",
    country="US",
    exchange="NASDAQ",
    market_cap_higher=100_000_000_000,
    is_etf=False,
)

# Show the five largest
semiconductors[["Name", "Market Cap", "Beta", "Price", "Dividend"]].head()
예를 들어 스크리너가 돌려주는 가장 큰 5개 기업은 아래와 같습니다.
| Symbol | Name | Market Cap | Beta | Price | Dividend |
|---|---|---|---|---|---|
| NVDA | NVIDIA Corporation | 5084136000000 | 2.216 | 210.96 | 0.28 |
| AVGO | Broadcom Inc. | 1535581254973 | 1.476 | 321.68 | 2.6 |
| MU | Micron Technology, Inc. | 992877621000 | 2.226 | 877.55 | 0.565 |
| AMD | Advanced Micro Devices, Inc. | 843646776955 | 2.454 | 516.79 | 0 |
| INTC | Intel Corp. | 459679713584 | 2.23 | 86.96 | 0 |
그리고 아래에는 모두 시가총액 순으로 순위가 매겨져 있습니다.
시장 따라가기
이 안내의 나머지는 그중 셋인 엔비디아, AMD, 인텔을 따라갑니다. 한 줄로 툴킷에 불러오고, S&P 500이 벤치마크로 함께 옵니다.
from financetoolkit import Toolkit

# Initialize the Toolkit for Nvidia, AMD and Intel from 2018 to 2025
companies = Toolkit(
    ["NVDA", "AMD", "INTC"],
    api_key="FINANCIAL_MODELING_PREP_KEY",
    start_date="2017-12-31",
    end_date="2025-12-31",
)
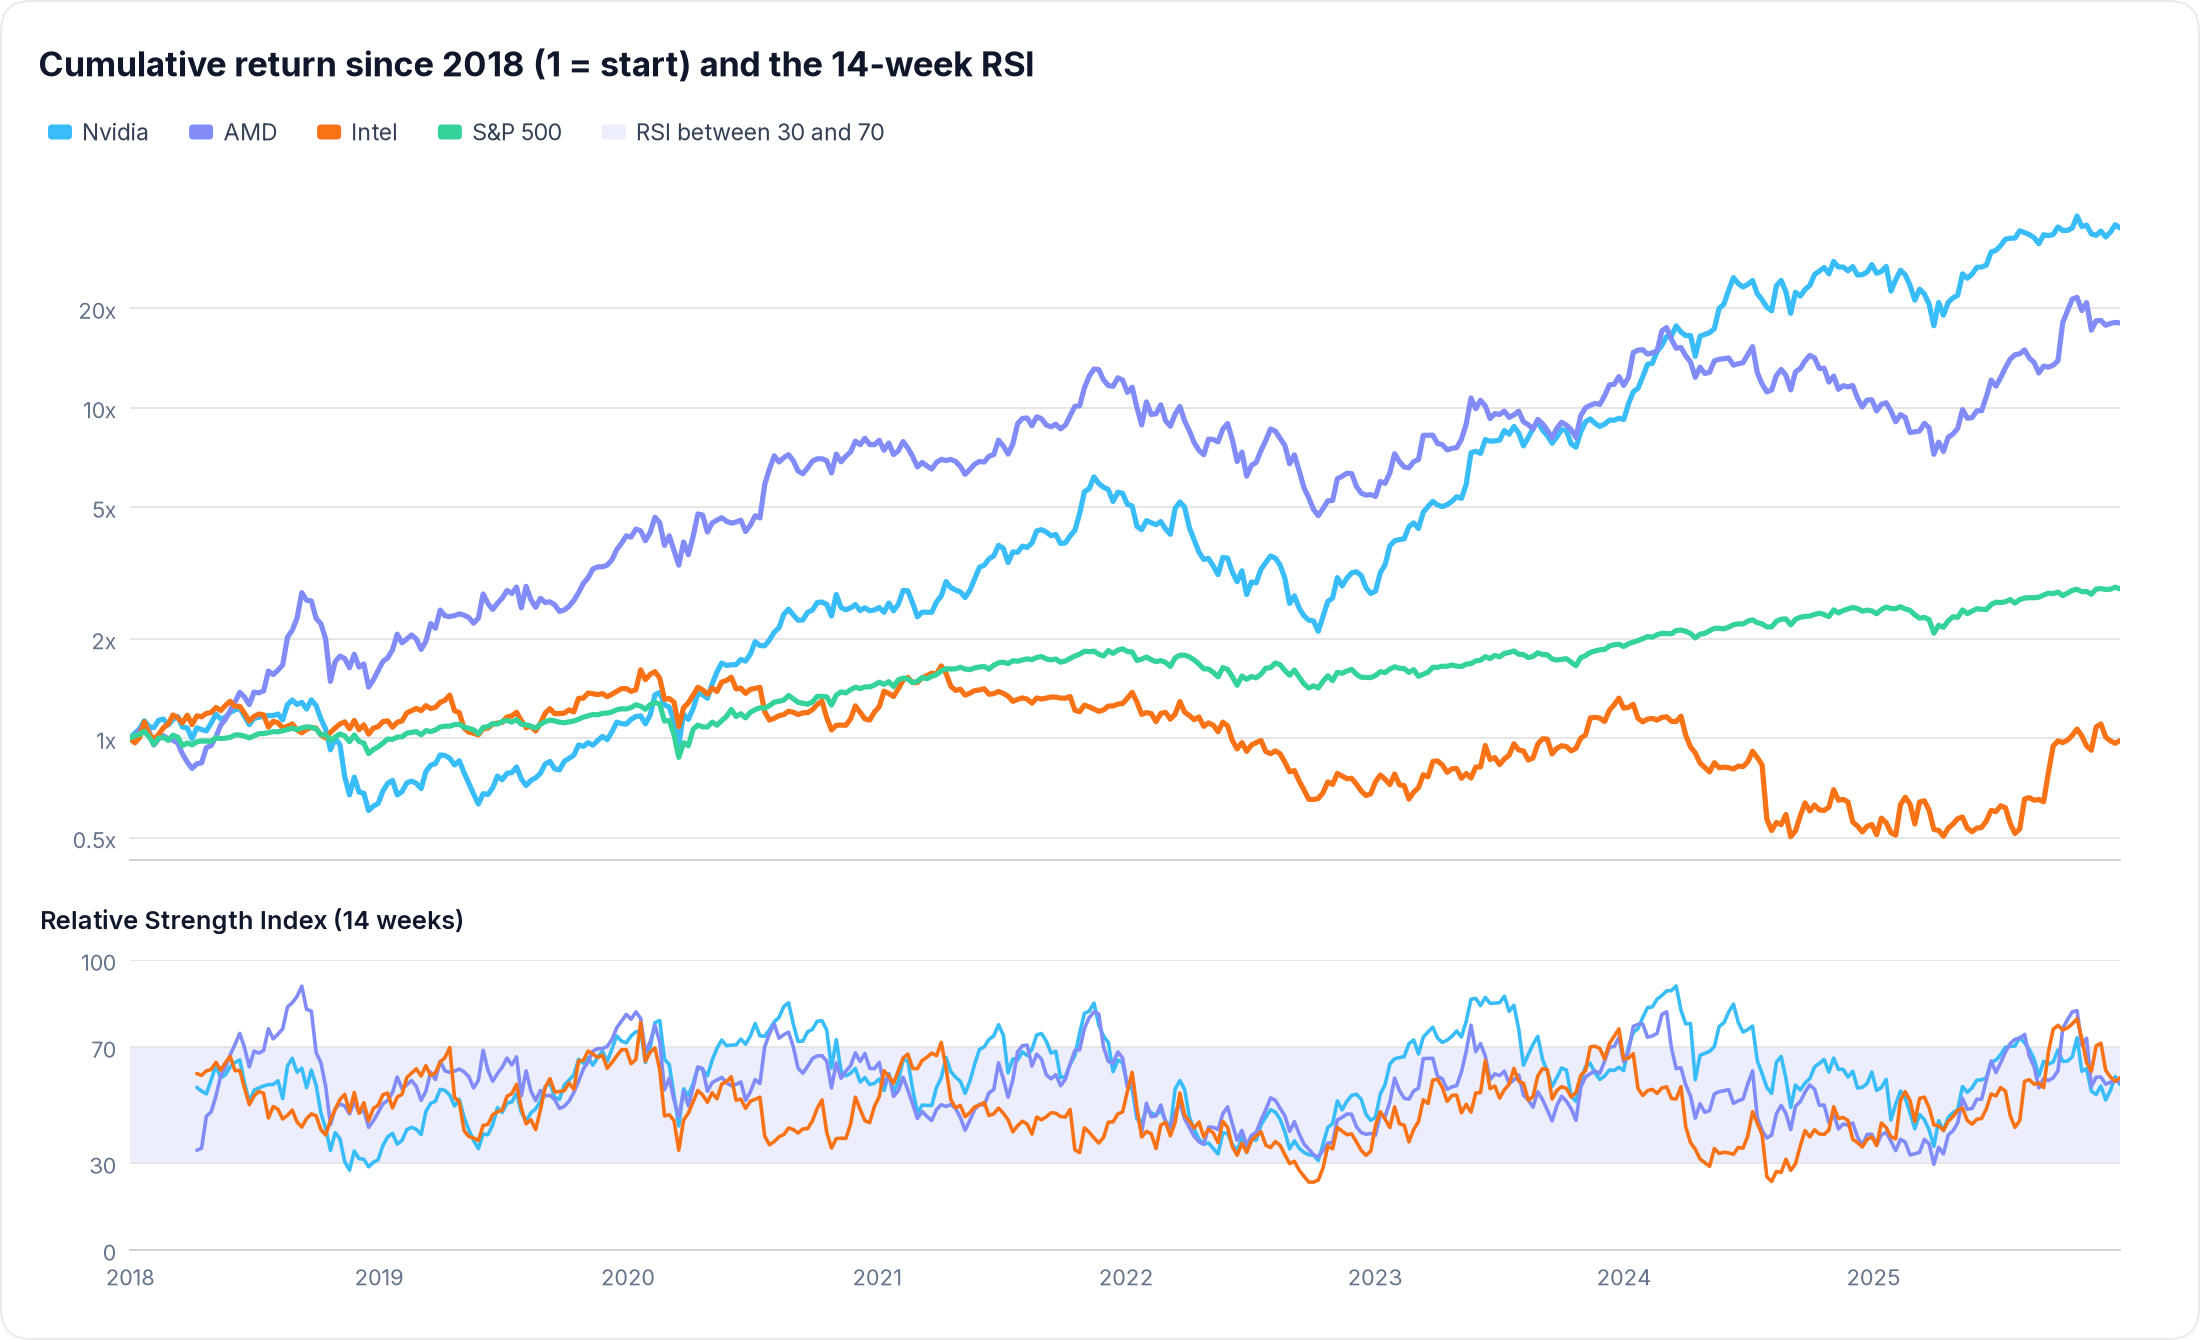
과거 데이터는 일 · 주 · 월 · 분기 · 연 단위로 나오고 기간마다 수익률과 누적 수익률이 붙습니다. 손익계산서 · 재무상태표 · 현금흐름표도 연간이나 분기로 나옵니다. 주가가 얼마나 갔는지와 상승이 과열이었는지는 별개의 문제입니다. 기술 지표 모듈이 50개 이상의 지표로 답합니다. 예를 들어 상대강도지수(RSI)는 0에서 100 사이를 움직이며 보통 70 위를 과매수로 읽습니다.
# Obtain weekly market data for all tickers and the benchmark
historical_data = companies.get_historical_data(period="weekly")

# The 14-week Relative Strength Index
relative_strength_index = companies.technicals.get_relative_strength_index(period="weekly", window=14)

# Show the highest RSI of each year
relative_strength_index.groupby(relative_strength_index.index.start_time.year).max()
예를 들어 해마다 가장 높은 주간 RSI는 아래와 같습니다.
| Date | NVDA | AMD | INTC | Benchmark |
|---|---|---|---|---|
| 2018 | 66.1087 | 90.9719 | 66.7363 | 66.0498 |
| 2019 | 73.8156 | 81.2446 | 69.8225 | 75.9305 |
| 2020 | 85.2337 | 82.1215 | 78.4827 | 80.2378 |
| 2021 | 85.1593 | 82.0983 | 71.5862 | 74.4751 |
| 2022 | 58.4343 | 58.9426 | 61.2806 | 59.9225 |
| 2023 | 87.5129 | 77.506 | 76.2332 | 71.4291 |
| 2024 | 91.0702 | 82.1403 | 67.6949 | 80.0566 |
| 2025 | 73.3514 | 82.5281 | 79.7429 | 71.6939 |
그리고 아래에는 세 기업의 누적 수익률이 S&P 500과 함께 그려져 있고, 그 밑에 RSI가 있습니다.
경쟁사 들여다보기
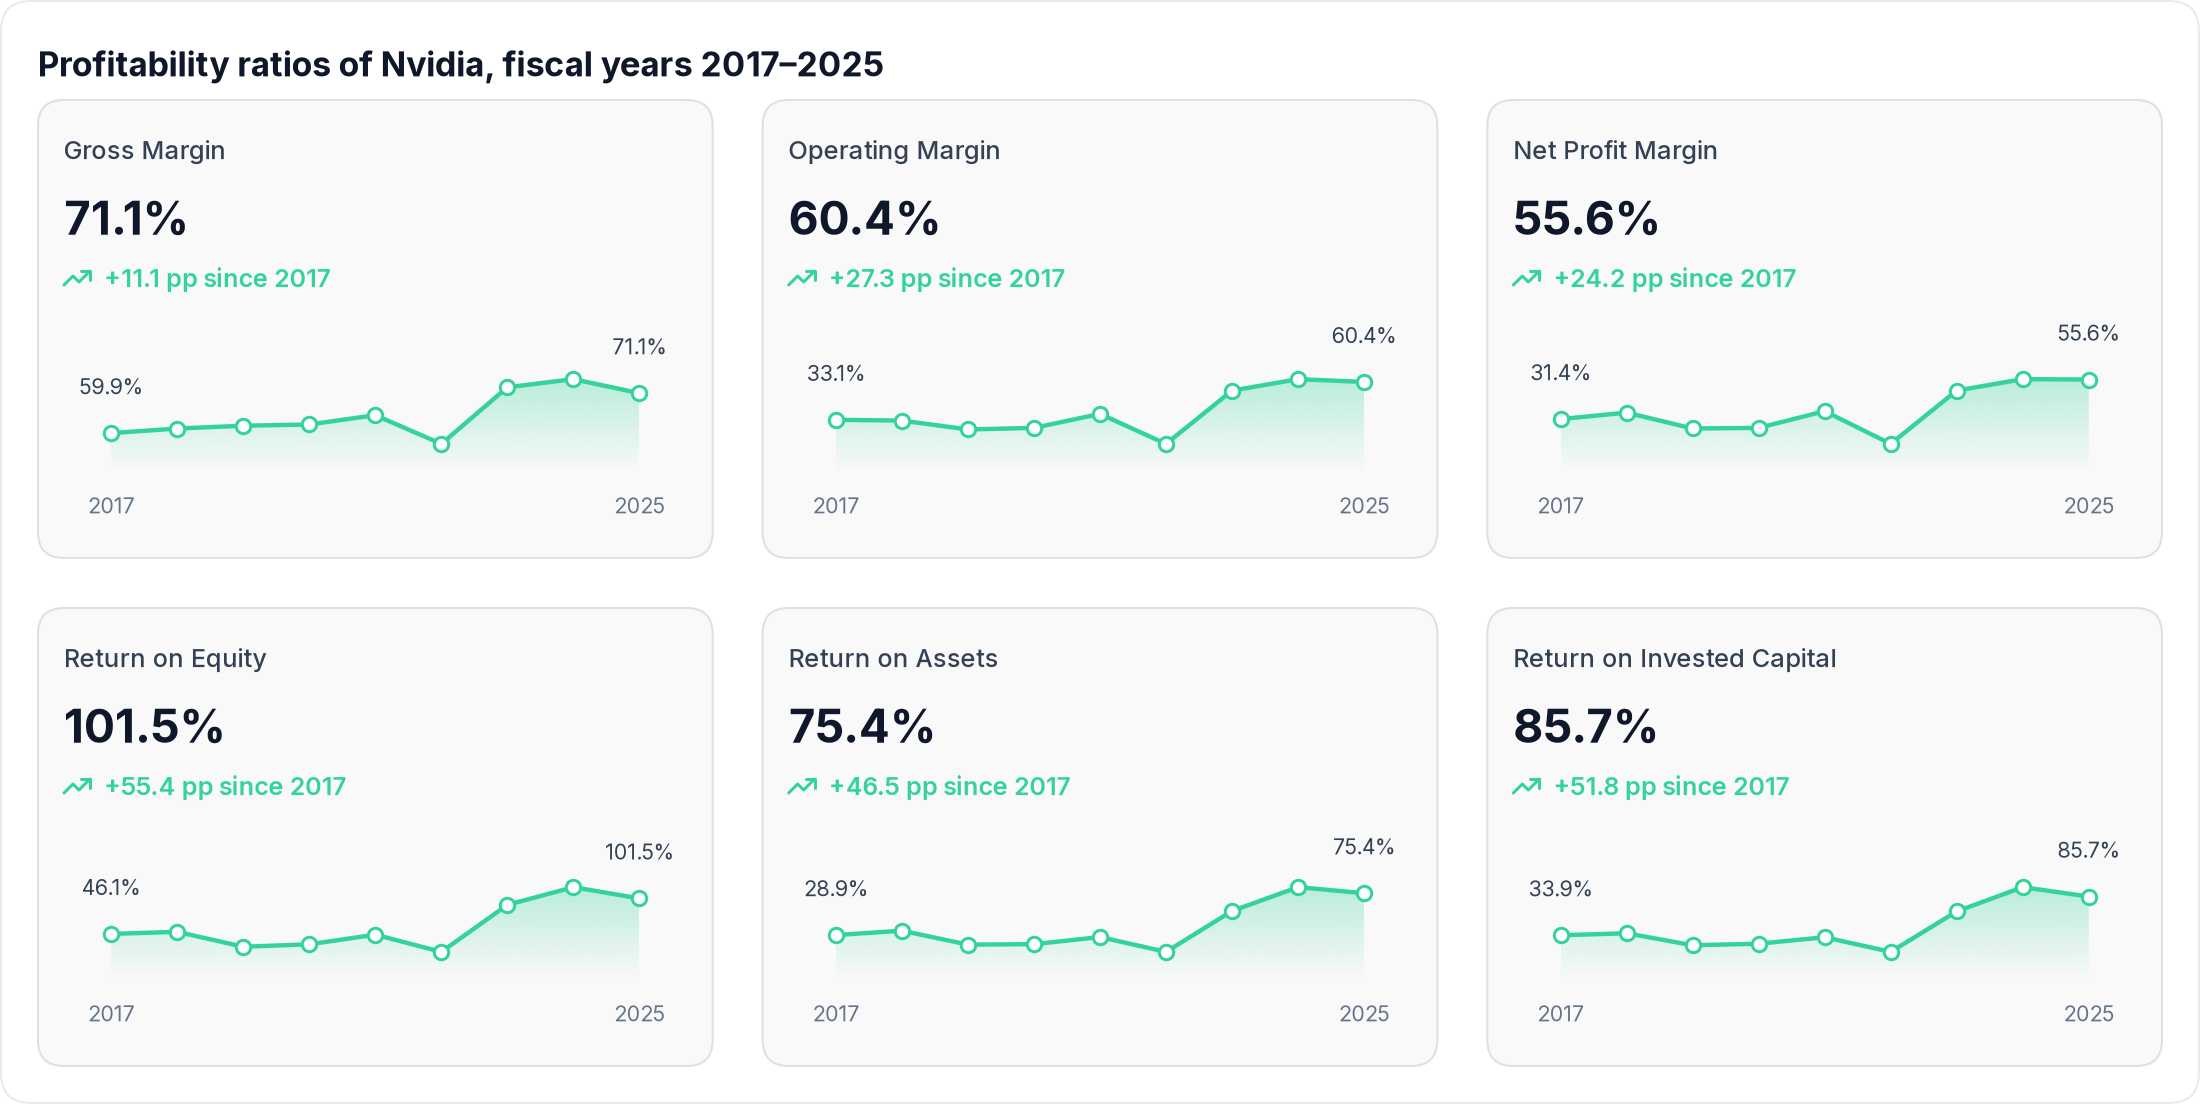
엔비디아의 주가는 다른 둘을 크게 앞섰고, 그렇다면 사업도 그만큼 잘했는지 의문이 생깁니다. 재무제표로부터 툴킷은 효율성 · 유동성 · 수익성 · 지급 능력 · 가치평가의 다섯 범주에서 80개 이상의 비율을 계산합니다. 비율마다 함수가 있고 collect_ 함수는 한 범주 전체를 돌려줍니다.
# Collect all Profitability Ratios for all tickers
profitability_ratios = companies.ratios.collect_profitability_ratios()

# Show the first ratios for Nvidia
profitability_ratios.loc["NVDA"].head()
예를 들어 엔비디아의 수익성 비율 일부는 아래와 같습니다.
| 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023 | 2024 | 2025 | |
|---|---|---|---|---|---|---|---|---|---|
| Gross Margin | 0.5993 | 0.6121 | 0.6199 | 0.6234 | 0.6493 | 0.5693 | 0.7272 | 0.7499 | 0.7107 |
| Operating Margin | 0.3305 | 0.3247 | 0.2607 | 0.2718 | 0.3731 | 0.1566 | 0.5412 | 0.6242 | 0.6038 |
| Net Profit Margin | 0.3137 | 0.3534 | 0.2561 | 0.2598 | 0.3623 | 0.1619 | 0.4885 | 0.5585 | 0.556 |
| EBITDA Margin | 0.3509 | 0.347 | 0.2956 | 0.3376 | 0.4167 | 0.2138 | 0.566 | 0.6385 | 0.617 |
| Free Cash Flow Margin | 0.2995 | 0.2683 | 0.3913 | 0.2815 | 0.3021 | 0.1412 | 0.4435 | 0.4663 | 0.4477 |
그리고 아래에는 몇 가지를 최신 값과 해마다의 흐름으로 보여 줍니다.
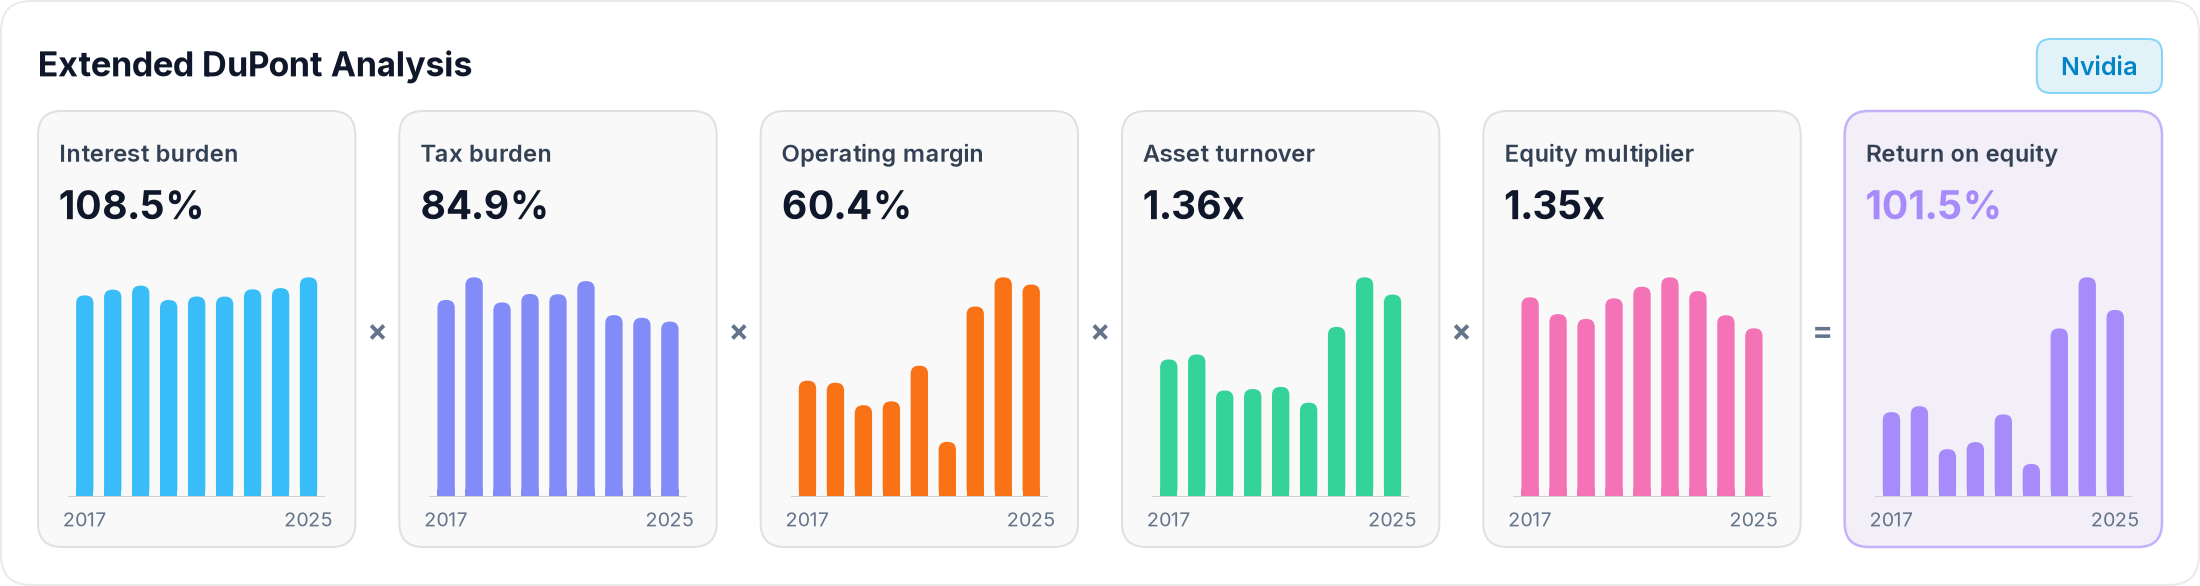
높은 자기자본이익률(ROE)은 마진에서, 회전율에서, 부채에서 나올 수 있습니다. 모델은 비율을 결합해 이를 가려냅니다. 확장 듀퐁 분석은 ROE를 곱해서 ROE가 되는 다섯 요소로 쪼갭니다. 이자 부담, 세금 부담, 영업이익률, 자산 회전율, 자기자본 승수입니다.
# Get the Extended DuPont Analysis for all tickers
extended_dupont_analysis = companies.models.get_extended_dupont_analysis()

# Show the results for Nvidia
extended_dupont_analysis.loc["NVDA"]
예를 들어 엔비디아의 요소는 아래와 같습니다.
| 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023 | 2024 | 2025 | |
|---|---|---|---|---|---|---|---|---|---|
| Interest Burden Ratio | 0.9956 | 1.0242 | 1.0436 | 0.9729 | 0.99 | 0.9898 | 1.0257 | 1.0316 | 1.0848 |
| Tax Burden Ratio | 0.9534 | 1.0629 | 0.9414 | 0.9825 | 0.981 | 1.0447 | 0.88 | 0.8674 | 0.8488 |
| Operating Profit Margin | 0.3305 | 0.3247 | 0.2607 | 0.2718 | 0.3731 | 0.1566 | 0.5412 | 0.6242 | 0.6038 |
| Asset Turnover | 0.9215 | 0.9551 | 0.7134 | 0.7233 | 0.7376 | 0.6319 | 1.1397 | 1.4718 | 1.3564 |
| Equity Multiplier | 1.5931 | 1.4592 | 1.4205 | 1.5846 | 1.6775 | 1.7525 | 1.6428 | 1.4499 | 1.3456 |
| Return on Equity | 0.4605 | 0.4926 | 0.2595 | 0.2978 | 0.4483 | 0.1793 | 0.9146 | 1.1918 | 1.0149 |
그리고 아래에는 각 요소를 회계연도마다 최신 값을 맨 위에 두고 보여 주며, 곱하면 ROE가 됩니다.
그 밖의 모델에는 가중평균자본비용, 알트만 Z-스코어, 피오트로스키 F-스코어, 내재 가치 평가가 있습니다. 거의 모든 함수가 한 기간에서 다음 기간으로의 성장을 보는 growth=True, 최근 12개월 수치를 보는 trailing=4, Z-스코어를 보는 standardize=True도 받습니다.
위험과 수익 따져 보기
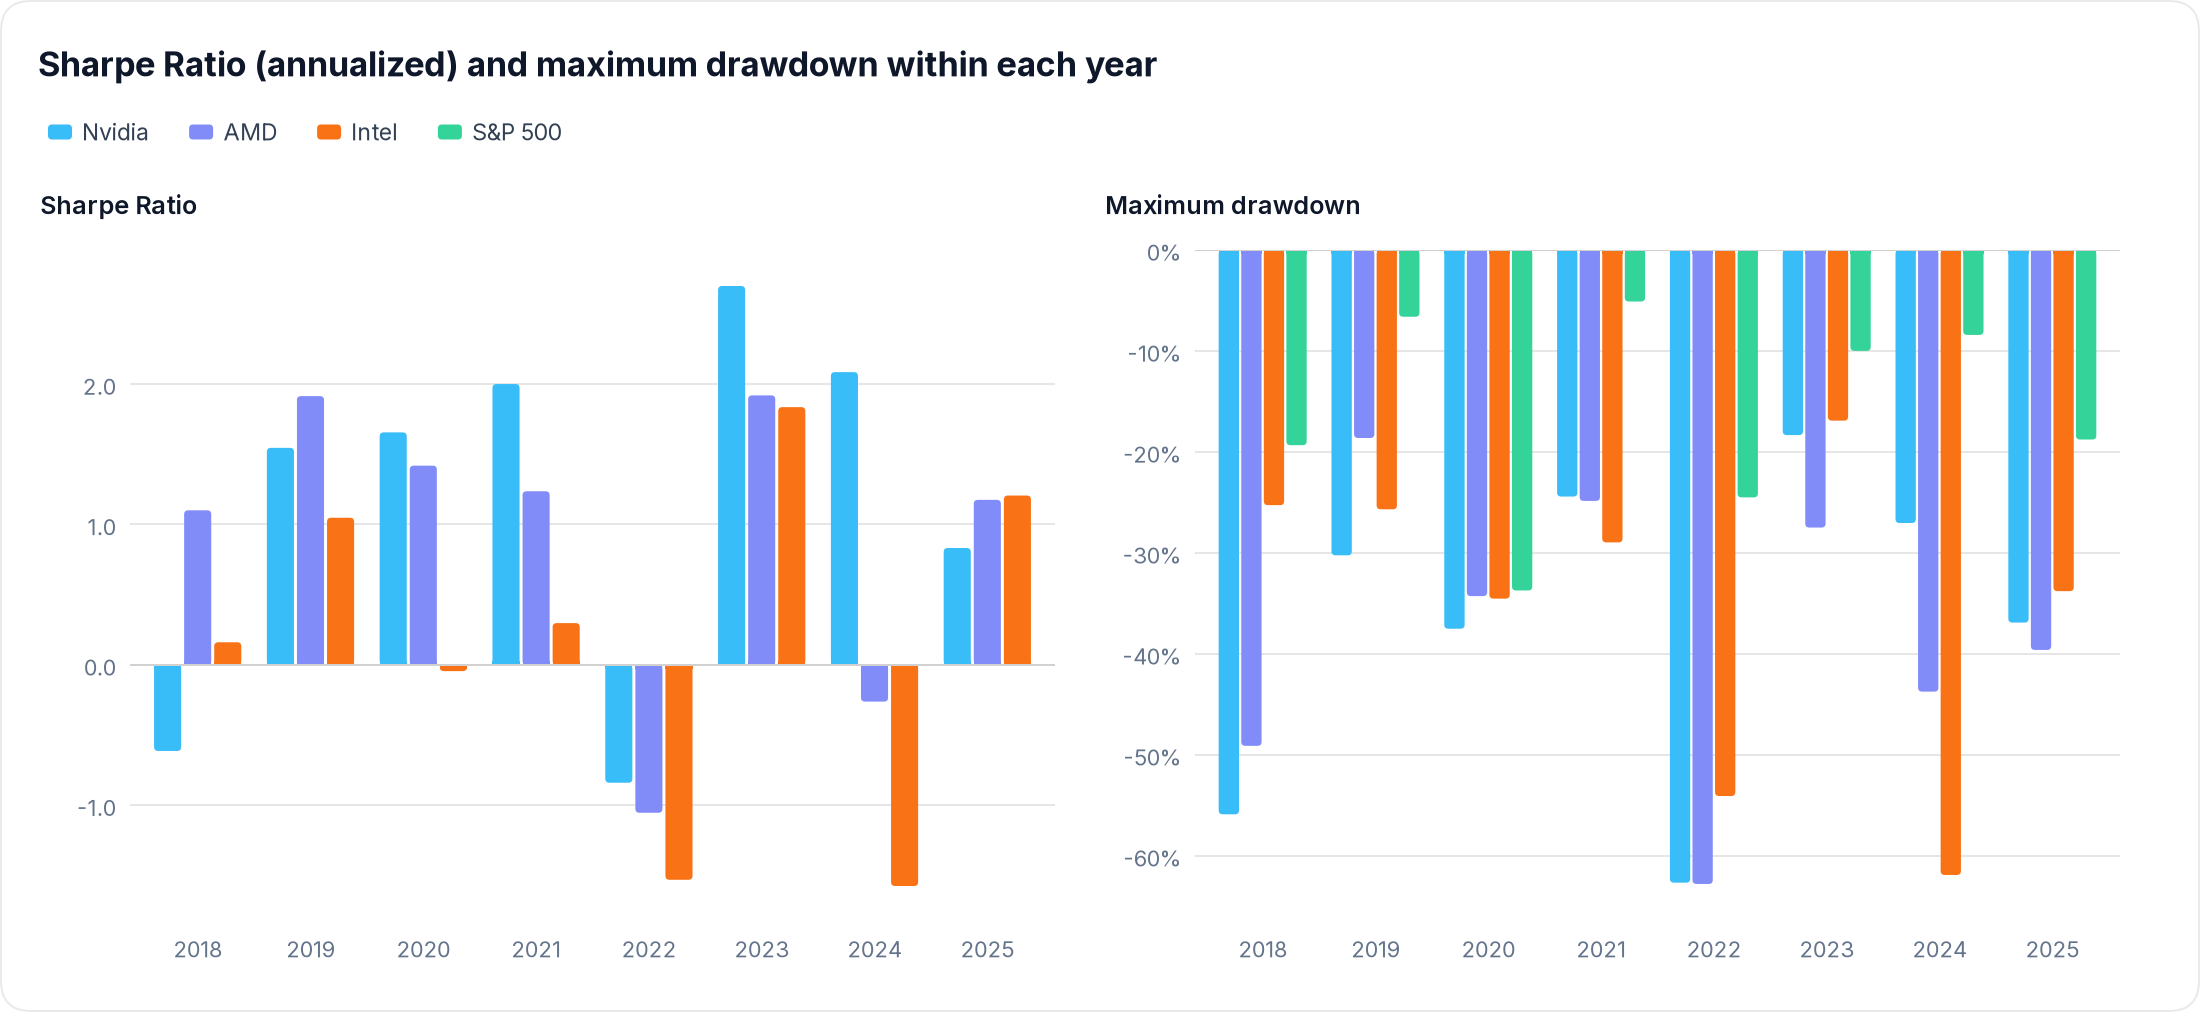
강한 사업이 매끄러운 주가를 뜻하지는 않습니다. 시장 데이터는 성과와 위험 모듈로 이어져 장중부터 연간까지 어떤 기간으로든 지표를 계산합니다.
# The annualized Sharpe Ratio for each year
sharpe_ratio = companies.performance.get_sharpe_ratio(period="yearly", annualize=True)

# The deepest fall within each year
maximum_drawdown = companies.risk.get_maximum_drawdown(period="yearly", within_period=True)

# Show the Sharpe Ratios
sharpe_ratio
예를 들어 연간 샤프 지수는 아래와 같습니다.
| Date | NVDA | AMD | INTC |
|---|---|---|---|
| 2018 | -0.613 | 1.1009 | 0.161 |
| 2019 | 1.5458 | 1.9143 | 1.048 |
| 2020 | 1.656 | 1.419 | -0.0445 |
| 2021 | 2.0003 | 1.2366 | 0.2976 |
| 2022 | -0.8393 | -1.0532 | -1.5306 |
| 2023 | 2.6986 | 1.9195 | 1.8358 |
| 2024 | 2.0851 | -0.2615 | -1.5749 |
| 2025 | 0.8325 | 1.1753 | 1.2061 |
그리고 아래에는 둘을 해마다 그리며, 최대 낙폭은 S&P 500과 함께 보여 줍니다.
두 모듈을 합치면 위험가치(VaR), GARCH, 젠센 알파, 자본자산가격결정모형(CAPM), 파마-프렌치 팩터 같은 70개 이상의 지표를 다룹니다. 대부분은 시간에 따라 움직이는 값을 위한 rolling=도 받습니다.
옵션 시장이 기대하는 것
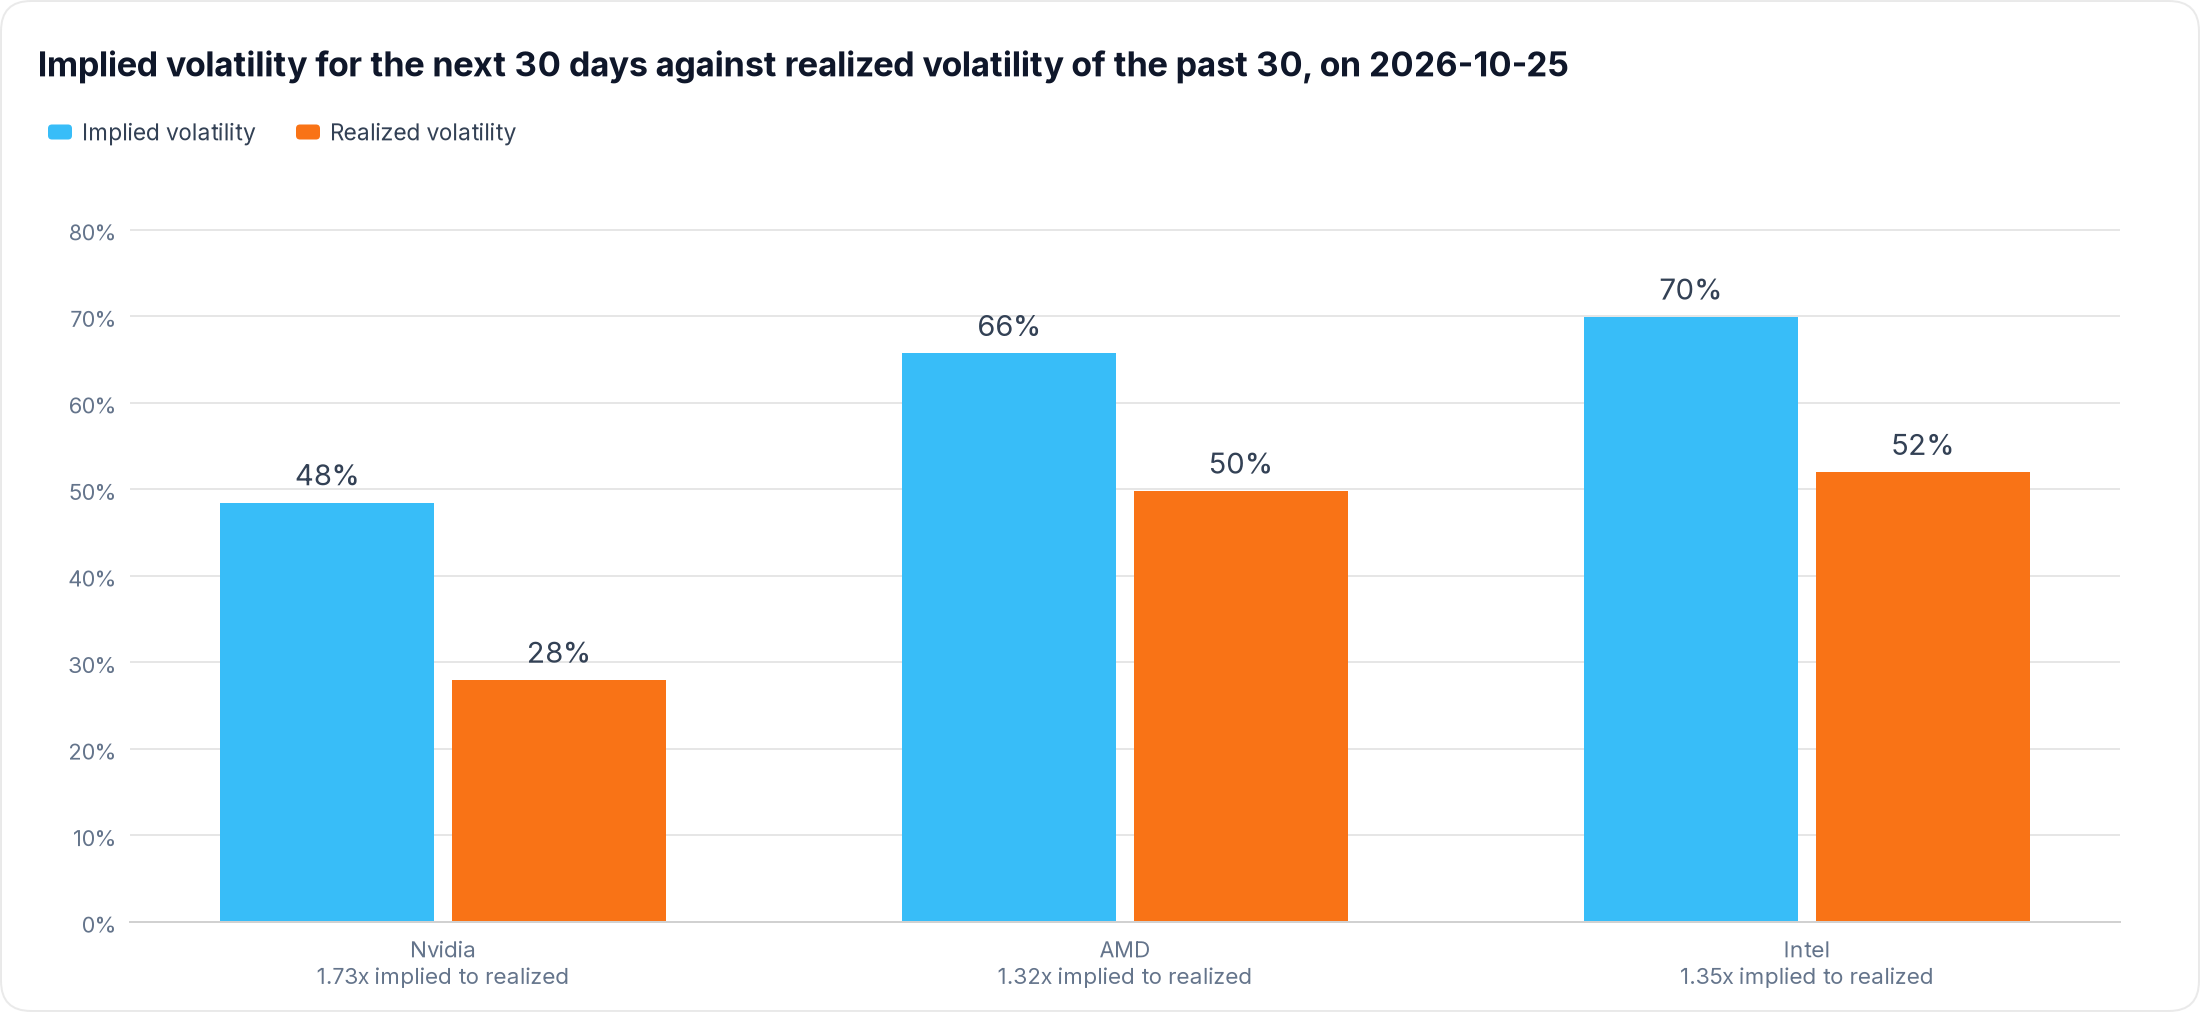
과거는 수익에 위험이 얼마나 따랐는지를 보여 주고, 옵션 시장은 앞으로의 위험에 가격을 매깁니다. 옵션 모듈은 블랙-숄즈, 이항 모형 등으로 옵션을 평가하고 3차까지 그릭스를 계산하며 실시간 옵션 체인을 읽습니다. 풋-콜 비율, 맥스 페인, 딜러 감마 노출, 변동성 스큐와 기간 구조, 내재 변동폭입니다. 체인은 오늘의 것이므로 아래 툴킷은 오늘까지 돌고, 수치는 이 README가 마지막으로 갱신된 날의 것입니다.
# Initialize the Toolkit up to today, as the option chains are live
companies_today = Toolkit(["NVDA", "AMD", "INTC"], api_key="FINANCIAL_MODELING_PREP_KEY")

# The volatility the options imply for the next 30 days against that of the past 30 days
companies_today.options.get_volatility_risk_premium(days=30)
내재 변동성은 모형 없이 VIX 방식으로 지평선 부근의 모든 외가격 옵션에서 읽고, 실현 변동성은 같은 일수 동안의 일간 수익률 변동성입니다. 예를 들어 두 값은 기업별로 아래와 같습니다.
| Implied Volatility | Realized Volatility | Volatility Risk Premium | Variance Risk Premium | Implied to Realized Ratio | |
|---|---|---|---|---|---|
| NVDA | 0.4845 | 0.2795 | 0.2049 | 0.1566 | 1.7331 |
| AMD | 0.657 | 0.498 | 0.159 | 0.1836 | 1.3192 |
| INTC | 0.6991 | 0.5196 | 0.1795 | 0.2188 | 1.3456 |
옵션은 보통 따라오는 것보다 많은 위험에 가격을 매깁니다. 매도자가 위험을 떠안는 대가를 받고 싶어 하기 때문입니다. 여기서도 옵션은 지난 한 달이 준 것보다 훨씬 많은 요동을 다음 한 달에 매겼습니다. 엔비디아의 옵션은 주가가 보인 변동성의 1.7배를 내재했습니다. 아래에는 기업별 내재 변동성과 실현 변동성이 나란히 그려져 있습니다.
경제 환경
세 기업 모두 미국에 상장되어 있고 몇 년 뒤의 이익을 기준으로 가치가 매겨지므로 미국 인플레이션과 금리가 주가의 배경이 됩니다. 위의 최대 낙폭이 셋 모두 절반 넘게 떨어졌음을 보여 주는 2022년에 인플레이션은 9%에 이르렀고 연준은 정책금리를 0.12%에서 4.38%로 올렸습니다.
경제 모듈은 60개 이상의 국가에서 GDP와 실업률부터 통화량과 금리까지 50개 이상의 지표를 다루고, 채권 모듈은 채권 수익률, 수익률 곡선, 중앙은행 금리, 개별 채권 계산을 더합니다. 둘 다 같은 Toolkit 인스턴스로, 또는 from financetoolkit import Economics, FixedIncome으로 단독으로 쓸 수 있습니다.
# Inflation on the same month a year earlier and the Federal Reserve's policy rate
inflation_rate = companies.economics.get_inflation_rate("United States", period="monthly")
policy_rate = companies.economics.get_central_bank_policy_rate("United States", period="monthly")

# The daily U.S. Treasury par yield curve
treasury_rates = companies.fixedincome.get_treasury_rates()

# Show the curve on the last trading day of each year
treasury_rates.groupby(treasury_rates.index.year).last()
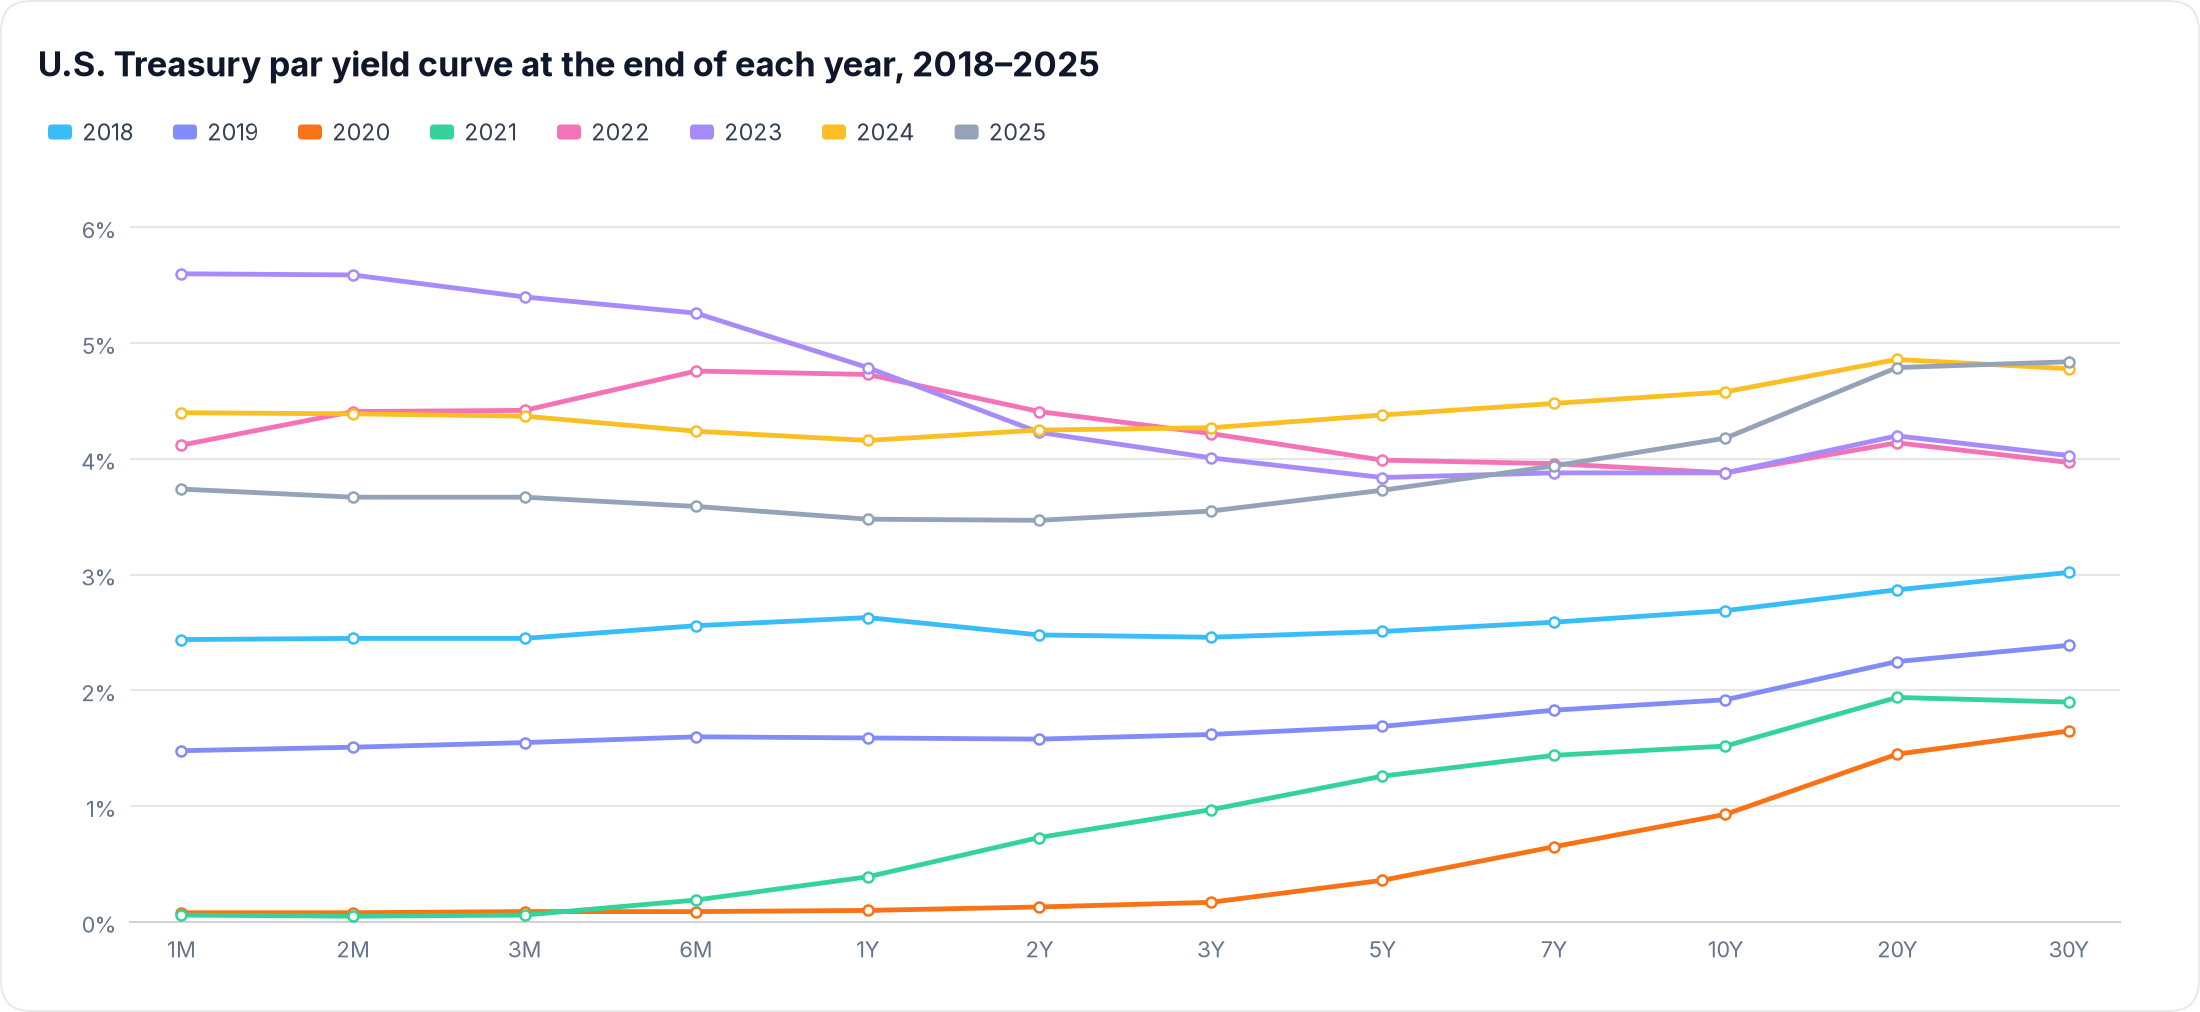
예를 들어 해마다 말의 수익률 곡선은 아래와 같습니다.
| Date | 1 Month | 2 Month | 3 Month | 6 Month | 1 Year | 2 Year | 3 Year | 5 Year | 7 Year | 10 Year | 20 Year | 30 Year |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 2018 | 0.0244 | 0.0245 | 0.0245 | 0.0256 | 0.0263 | 0.0248 | 0.0246 | 0.0251 | 0.0259 | 0.0269 | 0.0287 | 0.0302 |
| 2019 | 0.0148 | 0.0151 | 0.0155 | 0.016 | 0.0159 | 0.0158 | 0.0162 | 0.0169 | 0.0183 | 0.0192 | 0.0225 | 0.0239 |
| 2020 | 0.0008 | 0.0008 | 0.0009 | 0.0009 | 0.001 | 0.0013 | 0.0017 | 0.0036 | 0.0065 | 0.0093 | 0.0145 | 0.0165 |
| 2021 | 0.0006 | 0.0005 | 0.0006 | 0.0019 | 0.0039 | 0.0073 | 0.0097 | 0.0126 | 0.0144 | 0.0152 | 0.0194 | 0.019 |
| 2022 | 0.0412 | 0.0441 | 0.0442 | 0.0476 | 0.0473 | 0.0441 | 0.0422 | 0.0399 | 0.0396 | 0.0388 | 0.0414 | 0.0397 |
| 2023 | 0.056 | 0.0559 | 0.054 | 0.0526 | 0.0479 | 0.0423 | 0.0401 | 0.0384 | 0.0388 | 0.0388 | 0.042 | 0.0403 |
| 2024 | 0.044 | 0.0439 | 0.0437 | 0.0424 | 0.0416 | 0.0425 | 0.0427 | 0.0438 | 0.0448 | 0.0458 | 0.0486 | 0.0478 |
| 2025 | 0.0374 | 0.0367 | 0.0367 | 0.0359 | 0.0348 | 0.0347 | 0.0355 | 0.0373 | 0.0394 | 0.0418 | 0.0479 | 0.0484 |
아래에는 해마다 말의 수익률 곡선이 그려져 있습니다. 2021년 단기물의 거의 0에서 1년 뒤 모든 만기에서 4% 위로 올랐고, 2022년 말과 2023년 말처럼 단기 수익률이 장기보다 높으면 곡선이 역전된 것입니다.
경제적 관계
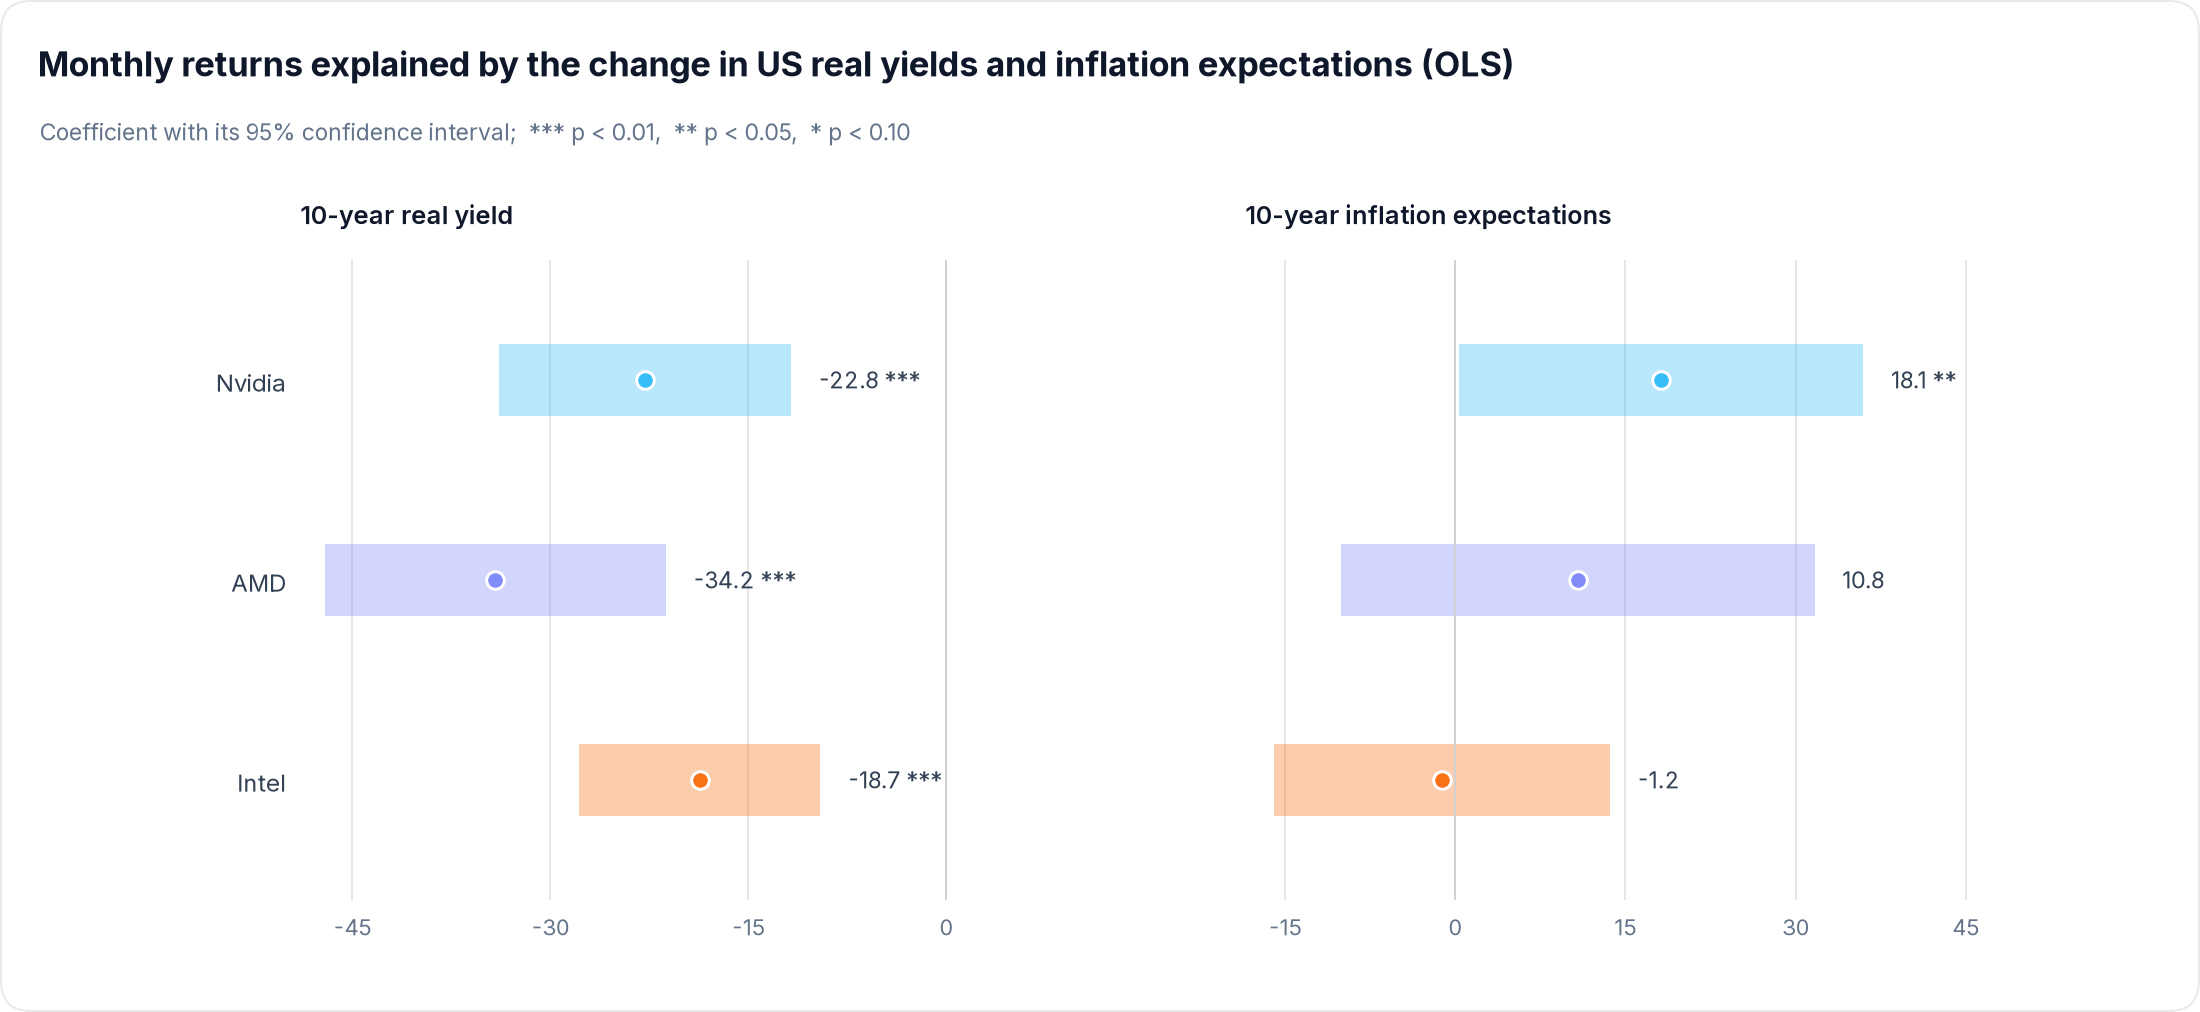
금리는 올랐고 주가는 떨어졌지만, 10년 국채 수익률은 두 부분으로 이루어집니다. 인플레이션 위에 투자자가 요구하는 수익인 실질 수익률, 그리고 그 10년 동안 투자자가 기대하는 인플레이션입니다. 계량경제 모듈은 statsmodels와 linearmodels로 만든 회귀 · 검정 · 예측으로 이런 요인을 가려냅니다(pip install financetoolkit[econometrics]). 툴킷을 통해서는 종목의 수익률을 분석하고, Econometrics(data=...)로 단독으로 쓰면 어떤 데이터든 분석합니다. 여기서는 세 기업의 월간 수익률을 미국 10년 실질 수익률과 10년 인플레이션 기대의 월간 변화 옆에 놓습니다.
import pandas as pd

from financetoolkit import Econometrics

# The US 10-year real yield and inflation expectations at the end of each month
real_yield = companies.economics.get_real_yield_curve("United States", period="monthly")
inflation_expectations = companies.economics.get_breakeven_inflation_expectations(
    "United States", period="monthly"
)

# The monthly change in both next to the monthly returns
monthly_returns = companies.get_historical_data(period="monthly")["Return"][["NVDA", "AMD", "INTC"]]
monthly_returns["Real Yield"] = real_yield[("United States", "10Y")].diff()
monthly_returns["Inflation Expectations"] = inflation_expectations[("United States", "10Y")].diff()

# The data are changes already
econometrics = Econometrics(data=monthly_returns, changes=None)

# Regress the return of each company on the change in the real yield and inflation expectations
regressions = pd.concat(
    {
        ticker: econometrics.get_ols(
            dependent_ticker=ticker, independent_tickers=["Real Yield", "Inflation Expectations"]
        )
        for ticker in ["NVDA", "AMD", "INTC"]
    }
)

# Show the results for Nvidia
regressions.loc["NVDA"]
예를 들어 엔비디아의 계수는 아래와 같습니다.
| Coefficient | Std. Error | t-Statistic | P-Value | |
|---|---|---|---|---|
| Intercept | 0.049 | 0.0129 | 3.8028 | 0.0003 |
| Real Yield | -22.8132 | 5.6358 | -4.0479 | 0.0001 |
| Inflation Expectations | 18.1329 | 9.1029 | 1.992 | 0.0493 |
아래에는 각 계수가 95% 신뢰구간과 함께 나와 있습니다. 실질 수익률이 0.1%포인트 오르면 월간 수익률이 엔비디아는 약 2.3%, AMD는 3.4%, 인텔은 1.9% 낮았습니다. 실질 수익률이 높을수록 먼 미래의 이익이 더 크게 할인되기 때문입니다. 인플레이션 기대는 훨씬 덜 중요합니다. 엔비디아만 계수가 유의 수준에 가깝습니다.
이 모듈은 단위근과 공적분 검정, 그레인저 인과성, 패널 데이터, 인과 추론, ARIMA · VAR · VECM 예측, 국면 전환, 시변 베타, 페어 트레이딩도 다룹니다.
섹터의 ETF 비교하기
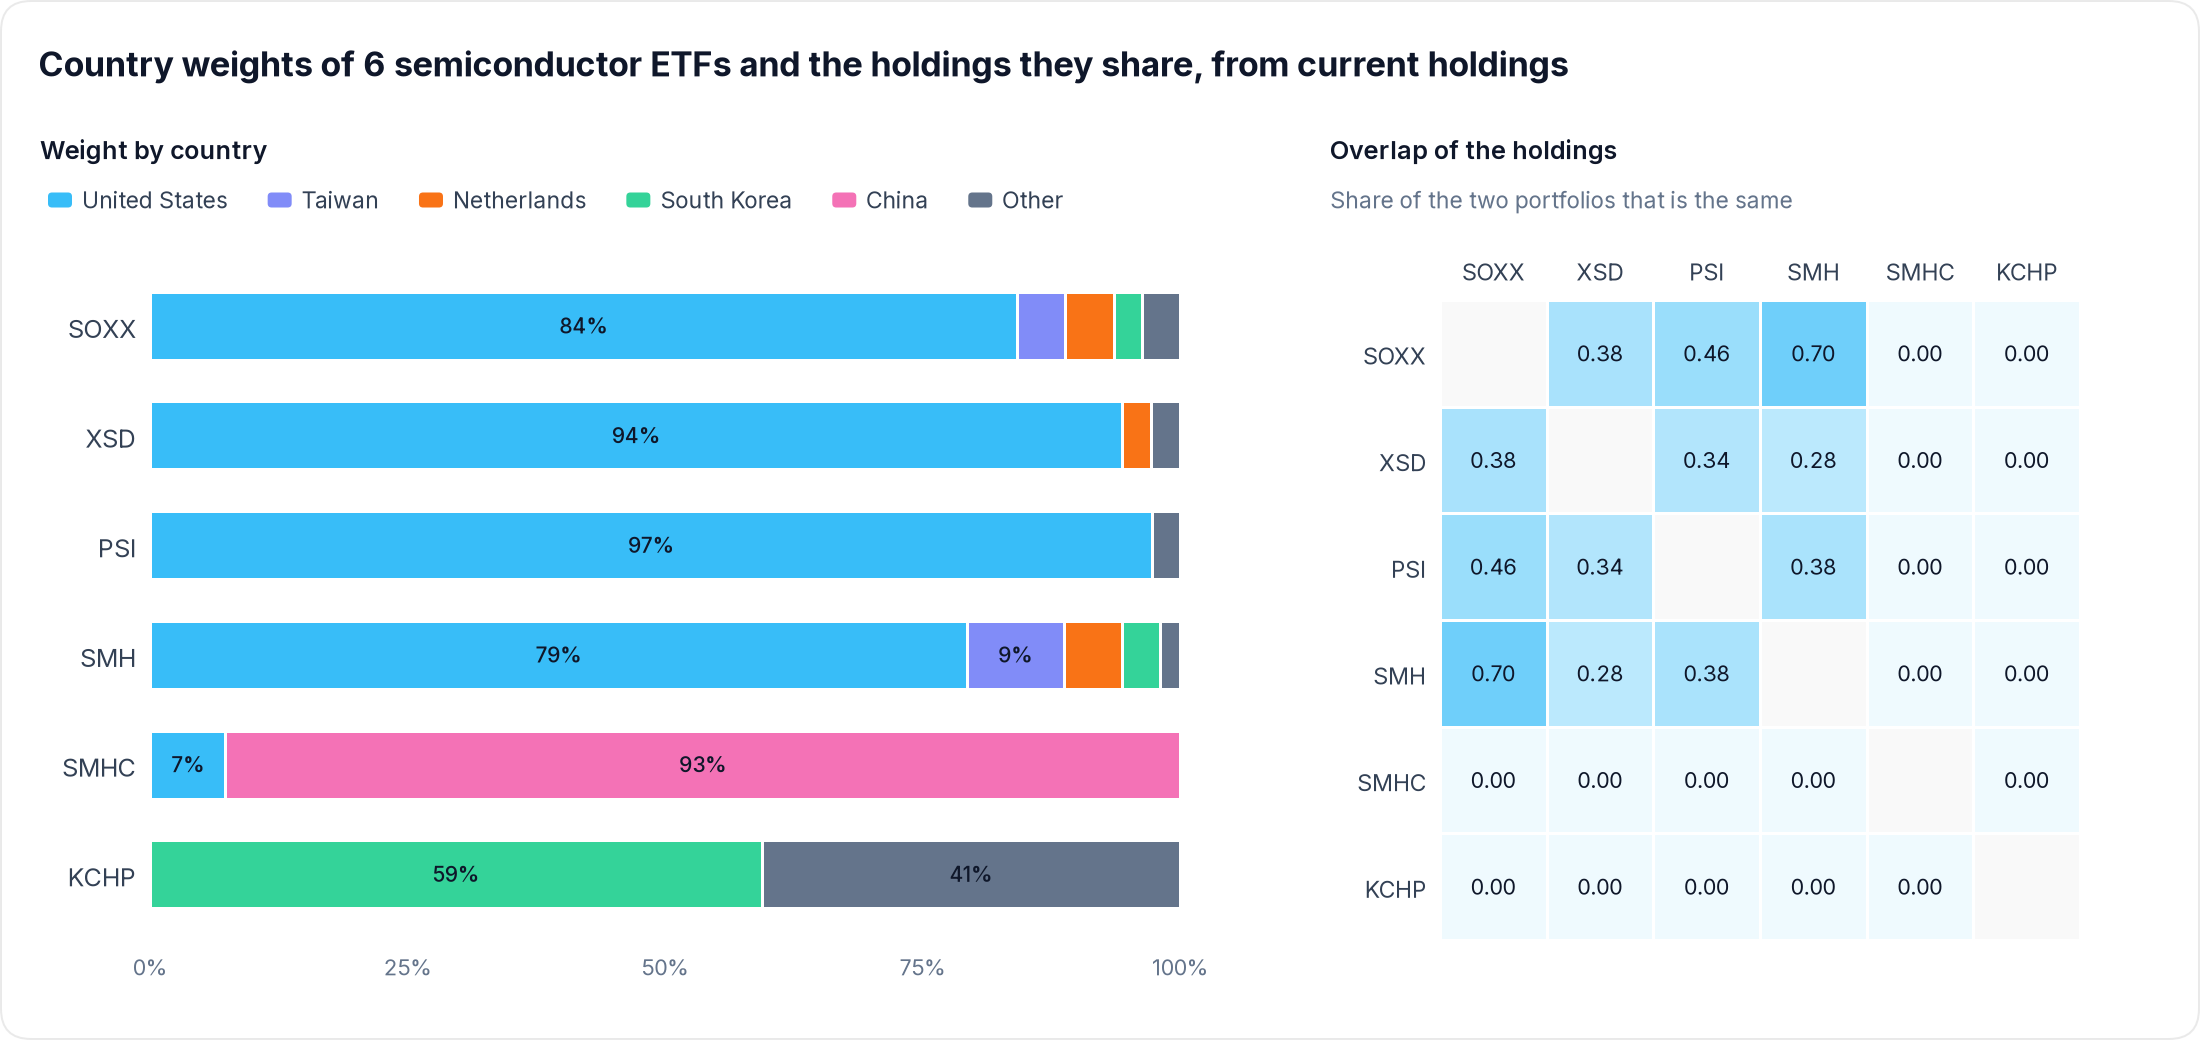
기업 셋을 고르는 대신 펀드는 산업 전체를 담습니다. ETF 모듈은 모든 펀드의 보유 종목, 섹터와 국가 비중, 추적, 집중도, 중복, 가치평가, 유동성을 분석합니다. 아래는 반도체 펀드 여섯 개를 비교합니다. 미국에 집중한 셋(SOXX, XSD, PSI), 글로벌 하나(SMH), 한 나라만 담은 둘인 중국(SMHC)과 한국(KCHP)입니다.
# Initialize the Toolkit for six semiconductor funds
funds = Toolkit(
    ["SOXX", "XSD", "PSI", "SMH", "SMHC", "KCHP"],
    api_key="FINANCIAL_MODELING_PREP_KEY",
    start_date="2017-12-31",
    end_date="2025-12-31",
)

# Where each fund invests, how concentrated it is and how much the funds hold of the same
country_weightings = funds.etf.get_country_weightings()
concentration = funds.etf.get_concentration()
overlap = funds.etf.get_overlap()

# Show the overlap between every pair of funds
overlap.round(2)
예를 들어 모든 펀드 쌍의 중복이 아래에 있습니다. 두 포트폴리오가 같은 비율입니다. 보유 종목은 오늘 기준인데, 펀드는 현재 보유 종목만 공개하기 때문입니다.
| SOXX | XSD | PSI | SMH | SMHC | KCHP | |
|---|---|---|---|---|---|---|
| SOXX | 1 | 0.38 | 0.46 | 0.7 | 0 | 0 |
| XSD | 0.38 | 1 | 0.34 | 0.28 | 0 | 0 |
| PSI | 0.46 | 0.34 | 1 | 0.38 | 0 | 0 |
| SMH | 0.7 | 0.28 | 0.38 | 1 | 0 | 0 |
| SMHC | 0 | 0 | 0 | 0 | 1.08 | 0 |
| KCHP | 0 | 0 | 0 | 0 | 0 | 1 |
미국 펀드 셋과 SMH는 대체로 같은 기업을 담고 있고, SOXX와 SMH는 포트폴리오의 70%를 공유합니다. SMH는 미국 밖에 가장 많이 담았는데 대만 9%, 네덜란드 6%입니다. 중국과 한국 펀드는 다른 어떤 펀드와도 겹치지 않으며, 이것이 한 섹터 안의 분산이 보여 주는 모습입니다. 아래에는 펀드별 국가 비중이 중복 옆에 그려져 있습니다.
분산 포트폴리오 만들기
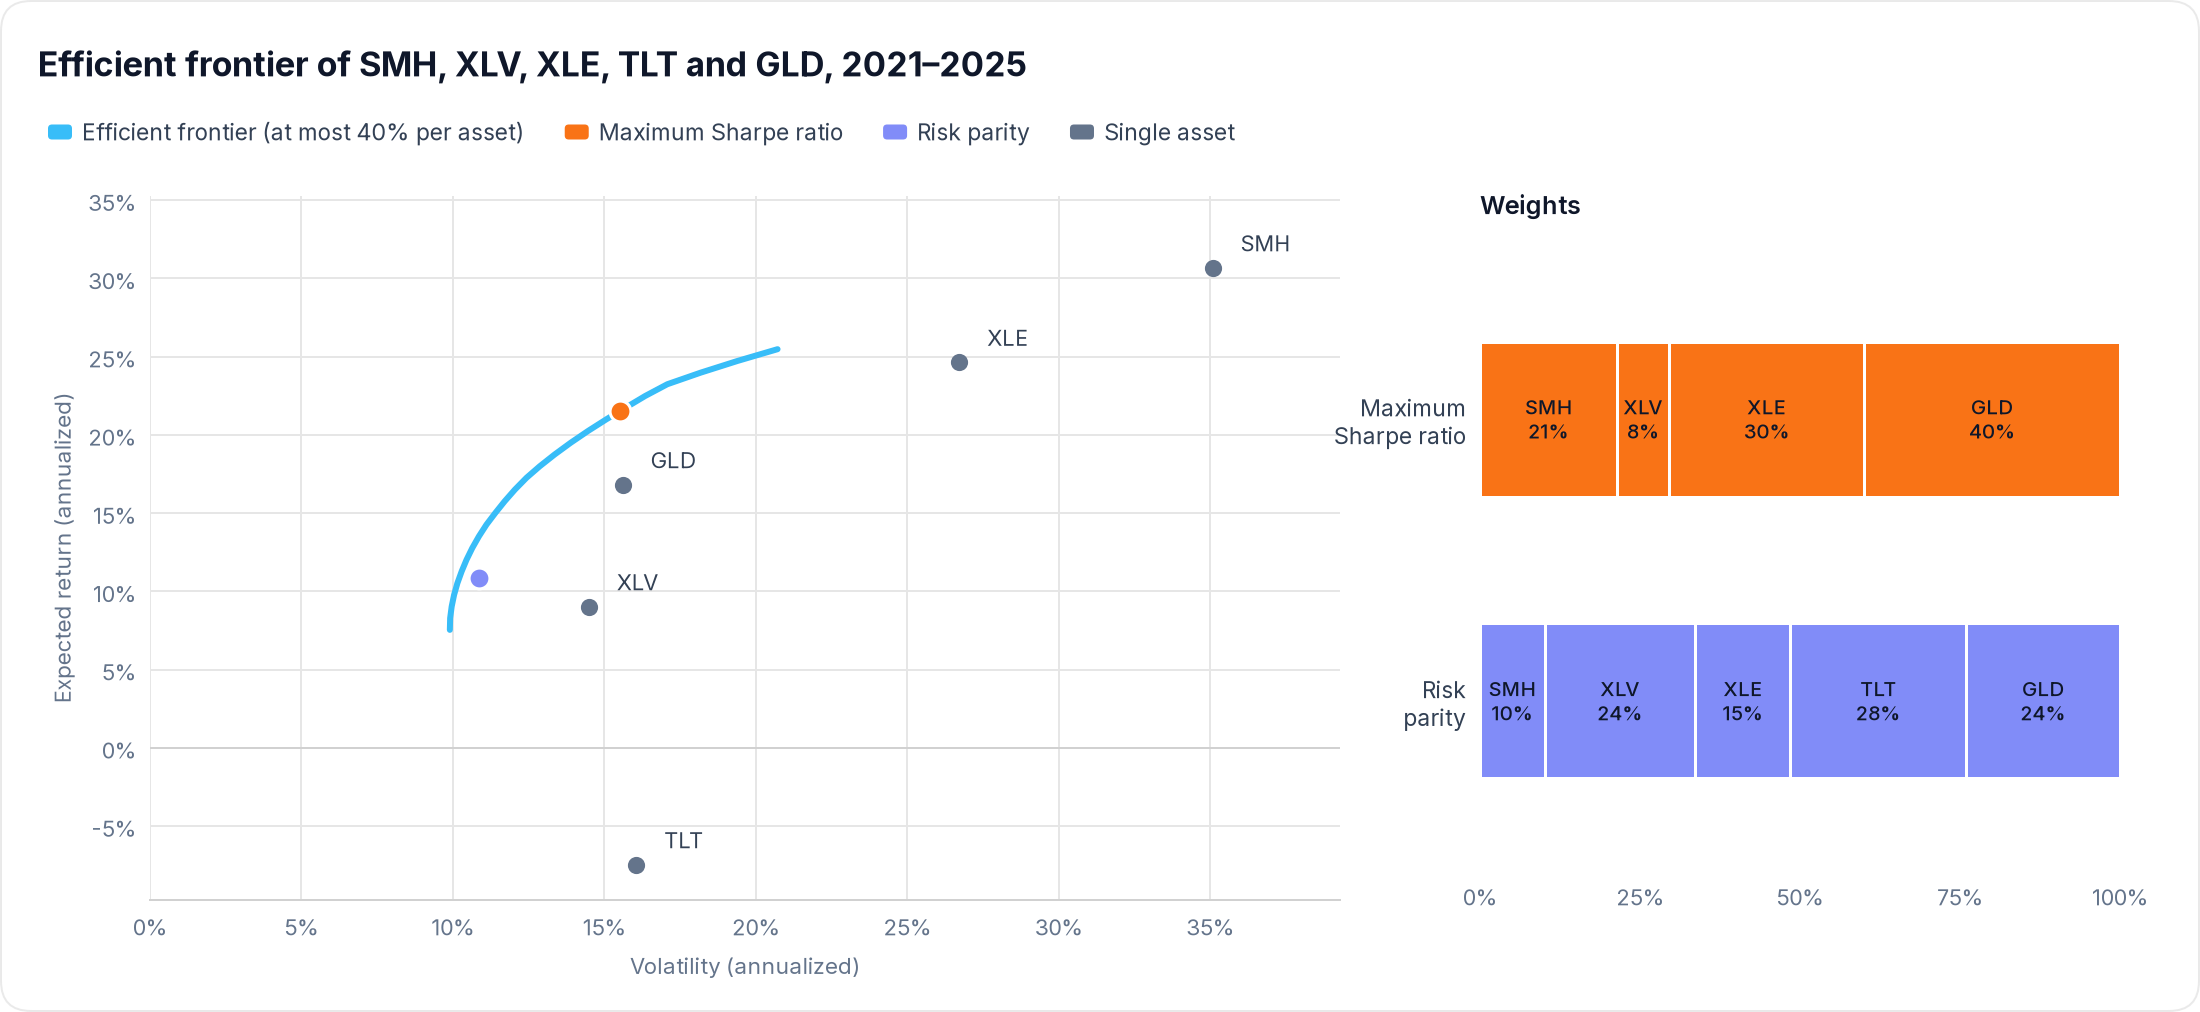
펀드는 섹터 안에 위험을 퍼뜨리지만 섹터는 여전히 하나로 움직입니다. 포트폴리오 모듈은 모든 Toolkit의 종목으로 포트폴리오를 만듭니다. 최소 분산, 최대 샤프 지수, 평균-분산, 리스크 패리티, 계층적 리스크 패리티, 계층적 동일 위험 기여, 중첩 군집 최적화, 최소 CVaR, 최소 낙폭, 최대 오메가와 CVaR 비율, 블랙-리터만, 최대 분산, 최소 추적 오차, 성장 최적(켈리) 비중, 효율적 투자선, 위험 기여, 스트레스 테스트, 성과 기여가 있습니다. 아래는 반도체 펀드에 헬스케어(XLV), 에너지(XLE), 장기 국채(TLT), 금(GLD)을 합칩니다.
# Initialize the Toolkit for funds across sectors and asset classes from 2021 to 2025
assets = Toolkit(
    ["SMH", "XLV", "XLE", "TLT", "GLD"],
    api_key="FINANCIAL_MODELING_PREP_KEY",
    start_date="2021-01-01",
    end_date="2025-12-31",
)

# The efficient frontier and the maximum Sharpe ratio portfolio, with at most 40% per asset
efficient_frontier = assets.portfolio.get_efficient_frontier(points=25, maximum_weight=0.4)
maximum_sharpe = assets.portfolio.get_maximum_sharpe_weights(maximum_weight=0.4)

# The portfolio in which every asset contributes the same share of the risk
risk_parity = assets.portfolio.get_risk_parity_weights()

# Show the risk parity portfolio
risk_parity
예를 들어 리스크 패리티 포트폴리오는 아래와 같습니다. 수익률과 변동성은 연율이고 위험 기여는 각 자산이 포트폴리오 변동성에서 차지하는 몫입니다.
| Weight | Expected Return | Volatility | Sharpe Ratio | Risk Contribution | |
|---|---|---|---|---|---|
| SMH | 0.1008 | 0.3067 | 0.3508 | 0.7782 | 0.2 |
| XLV | 0.2358 | 0.0901 | 0.1449 | 0.3889 | 0.2 |
| XLE | 0.1481 | 0.2463 | 0.2672 | 0.7954 | 0.2 |
| TLT | 0.275 | -0.0748 | 0.1606 | -0.6756 | 0.2 |
| GLD | 0.2403 | 0.1681 | 0.1562 | 0.8603 | 0.2 |
| Portfolio | 1 | 0.1084 | 0.1085 | 0.6888 | 1 |
아래에는 효율적 투자선이 두 포트폴리오와 각 자산 단독과 함께, 두 포트폴리오의 비중 옆에 그려져 있습니다.
포트폴리오 따라가기
종이 위의 최적 비중도 실제로 보유해야 합니다. Portfolio 클래스는 비중, 보유 주식 수, 내 거래, 또는 60/40과 올웨더 같은 13가지 고전 포트폴리오로 주어진 포트폴리오를 시간에 따라 따라갑니다. 아래는 리스크 패리티 비중을 2021년 초에 투자하고 해마다 비중으로 되돌리며 오늘까지 따라갑니다.
from financetoolkit import Portfolio

# Invest the risk parity weights and rebalance every year
portfolio = Portfolio(
    weights=risk_parity,
    start_date="2021-01-01",
    rebalancing="yearly",
    api_key="FINANCIAL_MODELING_PREP_KEY",
)

# Get an overview of the positions against the benchmark
overview = portfolio.get_portfolio_overview()

# Show the main figures
overview[["Weight", "Return", "Benchmark Return", "Volatility", "Alpha", "Beta"]]
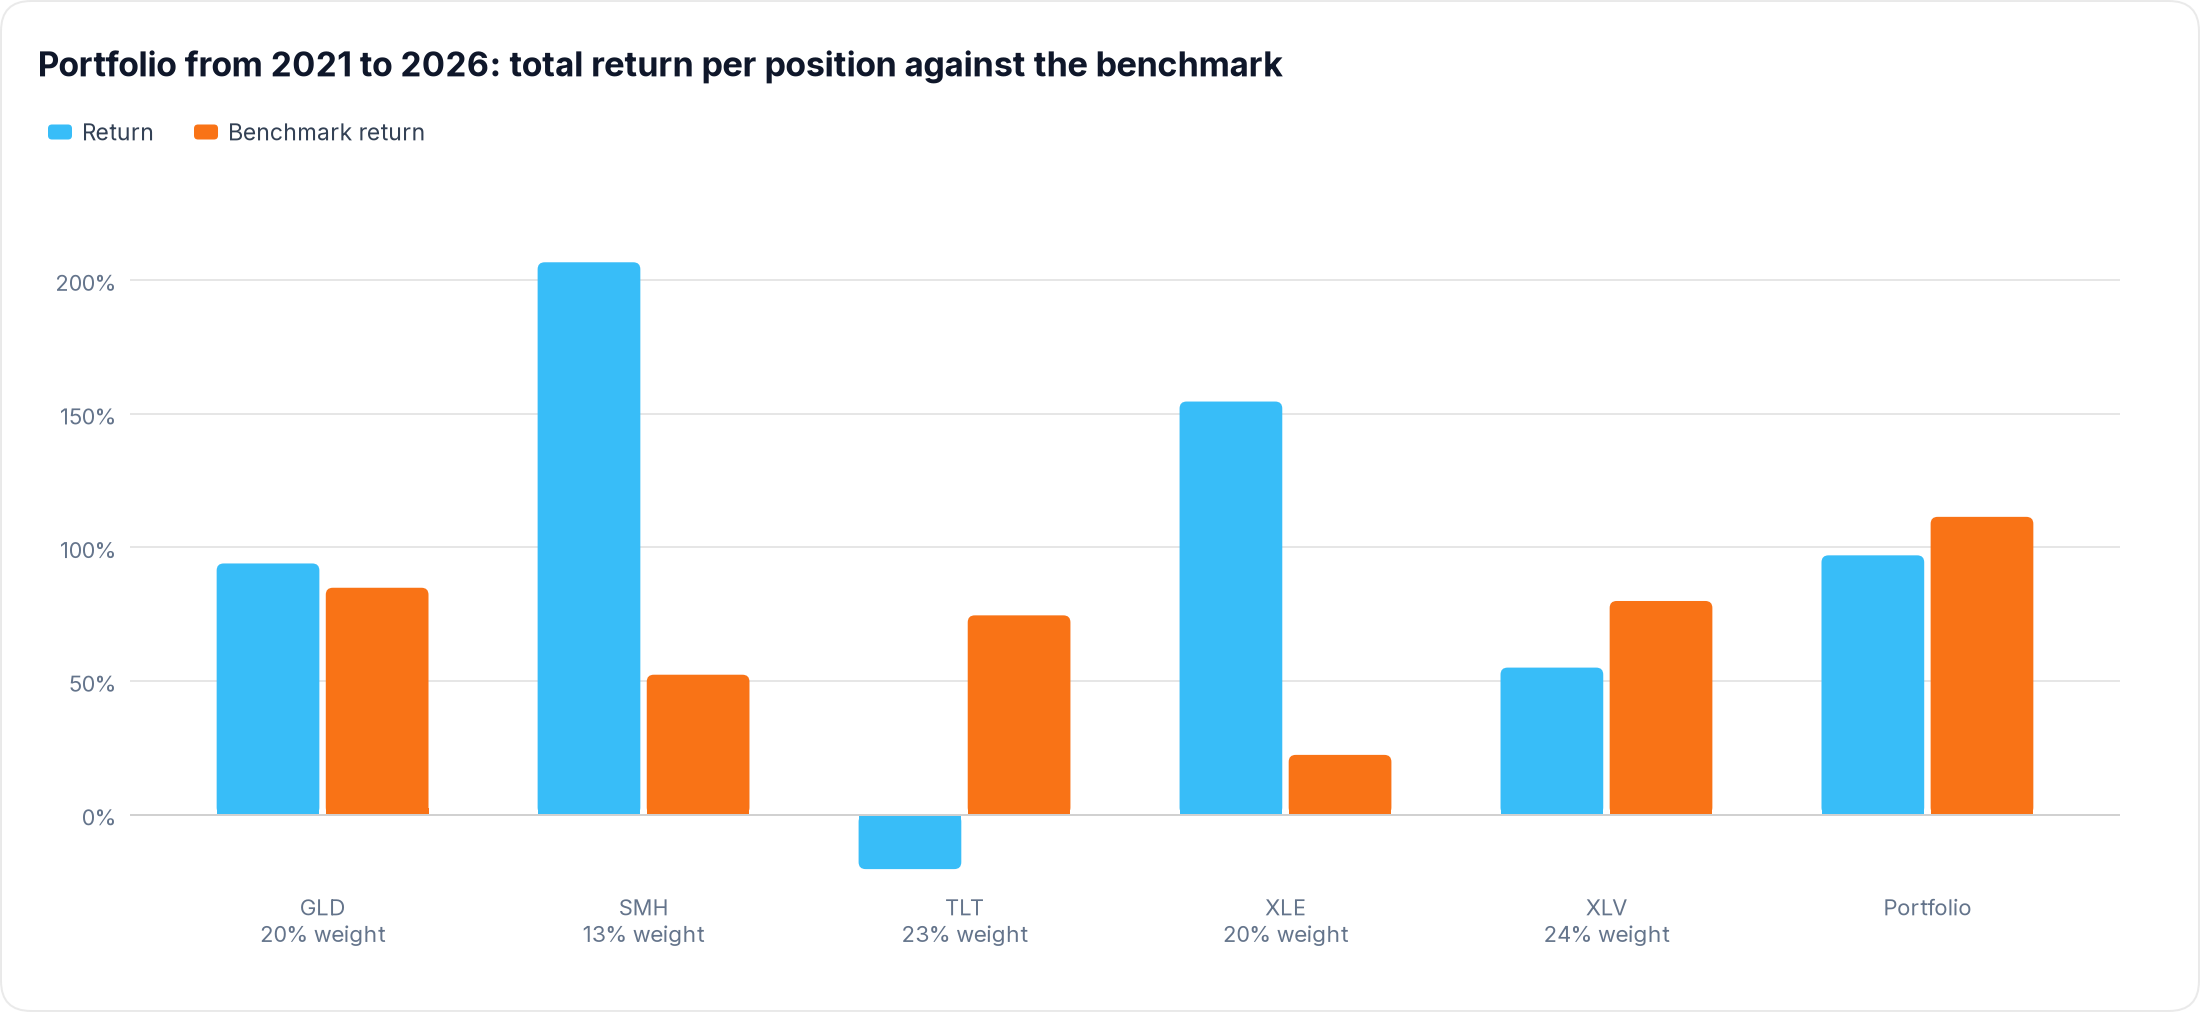
예를 들어 각 포지션의 주요 수치는 아래와 같습니다.
| Identifier | Weight | Return | Benchmark Return | Volatility | Alpha | Beta |
|---|---|---|---|---|---|---|
| GLD | 0.1969 | 0.9399 | 0.849 | 0.2845 | 0.0909 | 0.8392 |
| SMH | 0.1307 | 2.0669 | 0.5236 | 0.4001 | 1.5433 | 2.4046 |
| TLT | 0.2273 | -0.2038 | 0.7457 | 0.096 | -0.9494 | 0.2198 |
| XLE | 0.2034 | 1.5458 | 0.2236 | 0.2212 | 1.3222 | -0.4119 |
| XLV | 0.2418 | 0.5502 | 0.7995 | 0.1632 | -0.2493 | 0.256 |
| Portfolio | 1 | 0.9703 | 1.1143 | 0.1047 | -0.144 | 0.5075 |
아래에는 각 포지션의 수익률이 같은 기간 벤치마크 수익률과 함께 그려져 있습니다.
더 알아보기
MCP 서버 소개 영상, 질문과 답변, 기여하기, 언급, 문의 절은 저장소 README 뒷부분에 있습니다.
⚠️ 투자 안내 이 소개는 오픈소스 도구를 알리기 위한 글이며 투자 권유가 아닙니다. 이 도구가 내놓은 결과를 따른 매매의 손실 책임은 사용자에게 있습니다.
저장소: JerBouma/FinanceToolkit · 라이선스: MIT
평점
- 5점
- 0
- 4점
- 0
- 3점
- 0
- 2점
- 0
- 1점
- 0