요약
마이크로소프트의 AI 퀀트 투자 플랫폼. 데이터 처리 · 모델 학습 · 백테스트 · 주문 집행까지 퀀트 연구 전 과정을 다뤄요
설명




아직 배포되지 않은 호환성 변경: 아티팩트 불러오기
새 소스 빌드는 하위 호환되지 않는 안전 기본값을 도입합니다. 레코더 불러오기가 제한됩니다. 저장한 모델/데이터셋을 다시 불러오거나, 온라인 · 지연 학습을 이어 가거나, DDG-DA를 쓴다면 trusted=True(CLI는 --trusted=True)로 동의하기 전에 아티팩트를 쓴 주체와 저장소 권한을 확인하세요. 메모리에서 새로 학습하거나 지원되는 데이터 전용 읽기는 동의가 필요 없습니다. HIST 매핑과 고빈도 캐시 경로도 이전(마이그레이션) 요건이 있습니다.
업그레이드하기 전에 아티팩트 불러오기 마이그레이션 가이드를 따르세요. main에 병합되면 새 PyPI 릴리스 전에 소스 설치에 영향을 줍니다. 이 변경은 그것을 담은 첫 태그 릴리스가 나오기 전까지 미배포 상태입니다.
💡 설정 기반 워크플로를 업그레이드하나요? 미배포 소스 변경(로컬
.py가져오기에는 구성 요소별trusted: true, 제한된 표현식, 명시적 확장 매핑)은 설정 마이그레이션 가이드를 보세요. 패키지 가져오기는 그대로 쓸 수 있습니다. 가이드는 내 체크아웃과 맞춰 보세요. PR 소스,main, 태그/PyPI 릴리스가 다를 수 있습니다.
📰 새 소식! 💖
최근 배포된 기능
소개: 산업 데이터 기반 R&D를 위한 LLM 기반 자율 진화 에이전트
퀀트 투자 R&D에서 팩터 자동 발굴과 모델 최적화를 지원하는 강력한 도구 RD-Agent📢를 공개합니다.
RD-Agent는 GitHub에서 쓸 수 있으며 ⭐ 별을 환영합니다!
자세한 내용은 RD-Agent 저장소를 방문하세요. 공개 데모 영상을 준비했습니다.
| 시나리오 | 데모 영상(영어) | 데모 영상(중국어) |
|---|---|---|
| 퀀트 팩터 발굴 | YouTube | YouTube |
| 보고서에서 퀀트 팩터 발굴 | YouTube | YouTube |
| 퀀트 모델 최적화 | YouTube | YouTube |
- 📃논문: R&D-Agent-Quant: A Multi-Agent Framework for Data-Centric Factors and Model Joint Optimization
- 👾코드: https://github.com/microsoft/RD-Agent/
@misc{li2025rdagentquant,
    title={R\&D-Agent-Quant: A Multi-Agent Framework for Data-Centric Factors and Model Joint Optimization},
    author={Yuante Li and Xu Yang and Xiao Yang and Minrui Xu and Xisen Wang and Weiqing Liu and Jiang Bian},
    year={2025},
    eprint={2505.15155},
    archivePrefix={arXiv},
    primaryClass={cs.AI}
}
| 기능 | 상태 |
|---|---|
| R&D-Agent-Quant 공개 | 퀀트 트레이딩에 R&D-Agent를 Qlib와 함께 적용 |
| 종단 간 학습을 위한 BPQP | 📈 곧 공개!(심사 중) |
| 🔥LLM 기반 자동 퀀트 팩토리🔥 | 🚀 2024년 8월 8일 ♾️RD-Agent에서 공개 |
| KRNN과 Sandwich 모델 | 📈 2023년 5월 26일 공개 |
| Qlib v0.9.0 릴리스 | 🐙 2022년 12월 9일 공개 |
| 강화학습 프레임워크 | 🔨📈 2022년 11월 10일 공개 |
| HIST와 IGMTF 모델 | 📈 2022년 4월 10일 공개 |
| Qlib 노트북 튜토리얼 | 📖 2022년 4월 7일 공개 |
| Ibovespa 지수 데이터 | 🍚 2022년 4월 6일 공개 |
| 시점(Point-in-Time) 데이터베이스 | 🔨 2022년 3월 10일 공개 |
| Arctic 공급자 백엔드와 호가창 데이터 예제 | 🔨 2022년 1월 17일 공개 |
| 메타러닝 기반 프레임워크와 DDG-DA | 📈🔨 2022년 1월 10일 공개 |
| 계획 기반 포트폴리오 최적화 | 🔨 2021년 12월 28일 공개 |
| Qlib v0.8.0 릴리스 | 🐙 2021년 12월 8일 공개 |
| ADD 모델 | 📈 2021년 11월 22일 공개 |
| ADARNN 모델 | 📈 2021년 11월 14일 공개 |
| TCN 모델 | 📈 2021년 11월 4일 공개 |
| 중첩 의사결정 프레임워크 | 🔨 2021년 10월 1일 공개 |
| 시간 라우팅 어댑터(TRA) | 📈 2021년 7월 30일 공개 |
| Transformer와 Localformer | 📈 2021년 7월 22일 공개 |
| Qlib v0.7.0 릴리스 | 🐙 2021년 7월 12일 공개 |
| TCTS 모델 | 📈 2021년 7월 1일 공개 |
| 온라인 서빙과 자동 모델 롤링 | 🔨 2021년 5월 17일 공개 |
| DoubleEnsemble 모델 | 📈 2021년 3월 2일 공개 |
| 고빈도 데이터 처리 예제 | 🔨 2021년 2월 5일 공개 |
| 고빈도 트레이딩 예제 | 📈 2021년 1월 28일 일부 코드 공개 |
| 고빈도 데이터(1분) | 🍚 2021년 1월 27일 공개 |
| Tabnet 모델 | 📈 2021년 1월 22일 공개 |
2021년 이전에 공개된 기능은 여기에 적지 않았습니다.
Qlib는 AI 중심의 오픈소스 양적 투자 플랫폼으로, 아이디어 탐색부터 실제 운용에 이르기까지 퀀트 투자에서 AI 기술의 잠재력을 실현하고 연구를 지원하며 가치를 만드는 것을 목표로 합니다. Qlib는 지도학습, 시장 동역학 모델링, 강화학습 등 다양한 머신러닝 모델링 패러다임을 지원합니다.
다양한 패러다임의 최신(SOTA) 퀀트 연구 성과와 논문이 Qlib에 계속 공개되어, 퀀트 투자의 핵심 과제를 함께 풀고 있습니다. 예를 들어 1) 지도학습으로 풍부하고 이질적인 금융 데이터에서 시장의 복잡한 비선형 패턴을 찾고, 2) 적응형 개념 드리프트 기술로 금융 시장의 동적 성질을 모델링하고, 3) 강화학습으로 연속적인 투자 결정을 모델링해 투자자가 매매 전략을 최적화하도록 돕습니다.
데이터 처리, 모델 학습, 백테스트의 전체 ML 파이프라인을 담고 있으며, 알파 탐색 · 위험 모델링 · 포트폴리오 최적화 · 주문 집행까지 퀀트 투자의 전 과정을 다룹니다. 자세한 내용은 논문 "Qlib: An AI-oriented Quantitative Investment Platform"을 보세요.
목차: 프레임워크 · 튜토리얼 · 데이터 · DevOps / 퀀트 연구의 주요 과제와 해법 / 계획 / Qlib 프레임워크 / 빠른 시작(설치, 데이터 준비, 자동 퀀트 연구 워크플로, 코드로 맞춤 퀀트 연구 워크플로 만들기) / 퀀트 데이터셋 동물원 / 학습 프레임워크 / Qlib 더 알아보기 / 오프라인 모드와 온라인 모드 / Qlib 데이터 서버 성능 / 관련 보고서 / 문의 / 기여
계획
개발 중인 새 기능(예상 공개 시기 순)입니다. 기능에 대한 의견은 매우 중요합니다.
Qlib 프레임워크
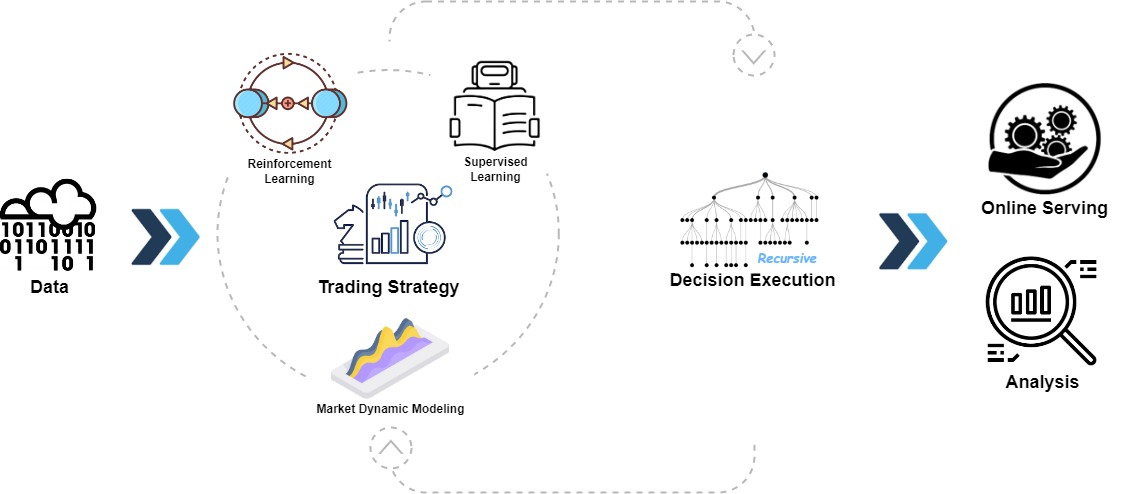
Qlib의 상위 수준 프레임워크는 위와 같습니다(자세한 설계 프레임워크는 깊이 들어가면 볼 수 있습니다). 구성 요소는 느슨하게 결합된 모듈로 설계되어 각각 단독으로 쓸 수 있습니다.
Qlib는 퀀트 연구를 뒷받침하는 강력한 인프라를 제공합니다. 데이터는 언제나 중요한 부분입니다. 다양한 학습 패러다임(예: 강화학습, 지도학습)과 여러 수준의 패턴(예: 시장 동역학 모델링)을 지원하는 강력한 학습 프레임워크가 설계되어 있습니다. 시장을 모델링하면 매매 전략이 실행될 거래 결정을 만들어 냅니다. 서로 다른 수준이나 입도의 여러 매매 전략과 집행기를 중첩해 함께 최적화하고 실행할 수 있습니다. 마지막으로 종합 분석을 제공하고, 모델을 낮은 비용으로 온라인 서빙할 수 있습니다.
빠른 시작
이 빠른 시작 안내는 다음을 보여 주려 합니다.
- _Qlib_로 완전한 퀀트 연구 워크플로를 만들고 아이디어를 시험하는 일은 매우 쉽습니다.
- 공개 데이터와 단순한 모델만으로도 머신러닝 기술이 실제 퀀트 투자에서 아주 잘 동작합니다.
다음은 Qlib 설치와 qrun으로 LightGBM을 돌리는 방법을 보여 주는 빠른 데모입니다. 하지만 안내에 따라 데이터를 먼저 준비해 두세요.
설치
Qlib이 지원하는 파이썬 버전은 다음과 같습니다.
| pip로 설치 | 소스에서 설치 | 그래프 | |
|---|---|---|---|
| Python 3.8 | ✔ | ✔ | ✔ |
| Python 3.9 | ✔ | ✔ | ✔ |
| Python 3.10 | ✔ | ✔ | ✔ |
| Python 3.11 | ✔ | ✔ | ✔ |
| Python 3.12 | ✔ | ✔ | ✔ |
참고:
- 파이썬 환경은 Conda로 관리하기를 권합니다.
conda밖의 파이썬을 쓰면 헤더 파일이 없어 일부 패키지 설치가 실패할 수 있습니다. - Python 3.6에서 cython을 설치하면 소스에서
Qlib을 설치할 때 오류가 납니다. Python 3.6을 쓴다면 3.8 이상으로 업그레이드하거나conda의 파이썬으로 소스 설치하기를 권합니다.
pip로 설치
다음 명령으로 Qlib을 쉽게 설치할 수 있습니다.
pip install pyqlib참고: pip는 최신 안정판 qlib을 설치합니다. 하지만 qlib의 main 브랜치는 활발히 개발 중입니다. main 브랜치의 최신 스크립트나 기능을 시험하려면 아래 방법으로 설치하세요.
소스에서 설치
최신 개발판 Qlib을 소스 코드로 설치할 수도 있습니다.
-
소스에서
Qlib을 설치하기 전에 일부 의존성을 설치해야 합니다.pip install numpy pip install --upgrade cython -
저장소를 복제하고 다음과 같이
Qlib을 설치합니다.git clone https://github.com/microsoft/qlib.git && cd qlib pip install . # `pip install -e .[dev]` is recommended for development. check details in docs/developer/code_standard_and_dev_guide.rst
팁: 내 환경에서 Qlib 설치나 예제 실행에 실패하면, 내 단계를 CI 워크플로와 견주어 보면 문제를 찾는 데 도움이 됩니다.
맥 팁: M1 맥을 쓴다면 OpenMP 의존성이 없어 LightGBM 휠 빌드에 문제가 생길 수 있습니다. 먼저 brew install libomp로 openmp를 설치한 뒤 pip install .를 실행하면 빌드가 됩니다.
데이터 준비
❗ 더 엄격한 데이터 보안 정책 때문에 공식 데이터셋을 일시적으로 쓸 수 없습니다. 커뮤니티가 기여한 이 데이터 소스를 써 볼 수 있습니다. 최신 데이터를 내려받는 예시입니다.
wget https://github.com/chenditc/investment_data/releases/latest/download/qlib_bin.tar.gz
mkdir -p ~/.qlib/qlib_data/cn_data
tar -zxvf qlib_bin.tar.gz -C ~/.qlib/qlib_data/cn_data --strip-components=1
rm -f qlib_bin.tar.gz
아래 공식 데이터셋은 가까운 시일 안에 다시 쓸 수 있게 됩니다.
다음 코드를 실행해 데이터를 불러오고 준비합니다.
모듈로 받기
# get 1d data
python -m qlib.cli.data qlib_data --target_dir ~/.qlib/qlib_data/cn_data --region cn

# get 1min data
python -m qlib.cli.data qlib_data --target_dir ~/.qlib/qlib_data/cn_data_1min --region cn --interval 1min
소스에서 받기
# get 1d data
python scripts/get_data.py qlib_data --target_dir ~/.qlib/qlib_data/cn_data --region cn

# get 1min data
python scripts/get_data.py qlib_data --target_dir ~/.qlib/qlib_data/cn_data_1min --region cn --interval 1min
이 데이터셋은 같은 저장소에 공개된 크롤러 스크립트로 모은 공개 데이터로 만들었습니다. 사용자도 그 스크립트로 같은 데이터셋을 만들 수 있습니다.
데이터가 야후 파이낸스에서 수집된 것이라 완벽하지 않을 수 있다는 점에 주의하세요. 품질 좋은 데이터셋이 있다면 직접 준비하기를 권합니다. 자세한 내용은 관련 문서를 보세요.
일 단위 데이터 자동 갱신(야후 파이낸스)
과거 데이터로 모델과 전략을 시험해 보려는 것뿐이라면 이 단계는 선택입니다.
한 번 수동으로(--trading_date 2021-05-25) 갱신한 뒤 자동 갱신으로 설정하기를 권합니다.
참고: Qlib이 제공하는 오프라인 데이터(용량을 줄이려 일부 필드를 뺐음)로는 증분 갱신을 할 수 없습니다. 야후 수집기로 야후 데이터를 처음부터 받은 뒤 증분 갱신하세요.
-
거래일마다 "qlib" 디렉터리로 데이터 자동 갱신(Linux)
-
crontab 사용:
crontab -e -
예약 작업 설정:
``` * * * * 1-5 python <script path> update_data_to_bin --qlib_data_1d_dir <user data dir> ``` -
스크립트 경로: scripts/data_collector/yahoo/collector.py
-
수동 갱신
python scripts/data_collector/yahoo/collector.py update_data_to_bin --qlib_data_1d_dir <user data dir> --trading_date <start date> --end_date <end date> -
trading_date: 거래일 시작
-
end_date: 거래일 끝(포함하지 않음)
데이터 건강 점검
-
데이터가 건강한지 점검하는 스크립트를 제공합니다. 다음 명령으로 확인하세요.
python scripts/check_data_health.py check_data --qlib_dir ~/.qlib/qlib_data/cn_data -
물론 검사 결과를 조정하는 매개변수를 더할 수도 있습니다.
python scripts/check_data_health.py check_data --qlib_dir ~/.qlib/qlib_data/cn_data --missing_data_num 30055 --large_step_threshold_volume 94485 --large_step_threshold_price 20
import qlib from qlib.data import D from qlib.constant import REG_CN
Initialization
mount_path = "~/.qlib/qlib_data/cn_data" # target_dir qlib.init(mount_path=mount_path, region=REG_CN)
Get stock data by Qlib
Load trading calendar with the given time range and frequency
print(D.calendar(start_time='2010-01-01', end_time='2017-12-31', freq='day')[:2])
Parse a given market name into a stockpool config
instruments = D.instruments('csi500') print(D.list_instruments(instruments=instruments, start_time='2010-01-01', end_time='2017-12-31', as_list=True)[:6])
Load features of certain instruments in given time range
instruments = ['SH600000'] fields = ['$close', '$volume', 'Ref($close, 1)', 'Mean($close, 3)', '$high-$low'] print(D.features(instruments, fields, start_time='2010-01-01', end_time='2017-12-31', freq='day').head())
## Docker 이미지
1. Docker Hub 저장소에서 이미지 받기
```bash
docker pull pyqlib/qlib_image_stable:stable
```
2. 새 Docker 컨테이너 시작
```bash
docker run -it --name <container name> -v <Mounted local directory>:/app pyqlib/qlib_image_stable:stable
```
3. 이제 Docker 환경 안에서 qlib 스크립트를 실행할 수 있습니다. 예시:
```bash
>>> python scripts/get_data.py qlib_data --name qlib_data_simple --target_dir ~/.qlib/qlib_data/cn_data --interval 1d --region cn
>>> python qlib/cli/run.py examples/benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml
```
4. 컨테이너 나가기
```bash
>>> exit
```
5. 컨테이너 다시 시작
```bash
docker start -i -a <container name>
```
6. 컨테이너 중지
```bash
docker stop <container name>
```
7. 컨테이너 삭제
```bash
docker rm <container name>
```
8. 더 자세히 알고 싶다면 문서를 보세요.
## 자동 퀀트 연구 워크플로
Qlib은 전체 워크플로(데이터셋 구축, 모델 학습, 백테스트, 평가)를 자동으로 실행하는 `qrun` 도구를 제공합니다. 다음 단계로 자동 퀀트 연구 워크플로를 시작하고 그래프 보고서 분석을 볼 수 있습니다.
1. 퀀트 연구 워크플로: lightgbm 워크플로 설정(workflow_config_lightgbm_Alpha158.yaml)으로 `qrun`을 실행합니다.
```bash
cd examples # Avoid running program under the directory contains `qlib`
qrun benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml
```
디버그 모드로 `qrun`을 쓰려면 다음 명령을 쓰세요.
```bash
python -m pdb qlib/cli/run.py examples/benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml
```
`qrun` 결과는 다음과 같으며, 결과 설명은 문서를 보세요.
```bash
'The following are analysis results of the excess return without cost.'
risk
mean 0.000708
std 0.005626
annualized_return 0.178316
information_ratio 1.996555
max_drawdown -0.081806
'The following are analysis results of the excess return with cost.'
risk
mean 0.000512
std 0.005626
annualized_return 0.128982
information_ratio 1.444287
max_drawdown -0.091078
```
`qrun`과 워크플로에 대한 자세한 문서가 있습니다.
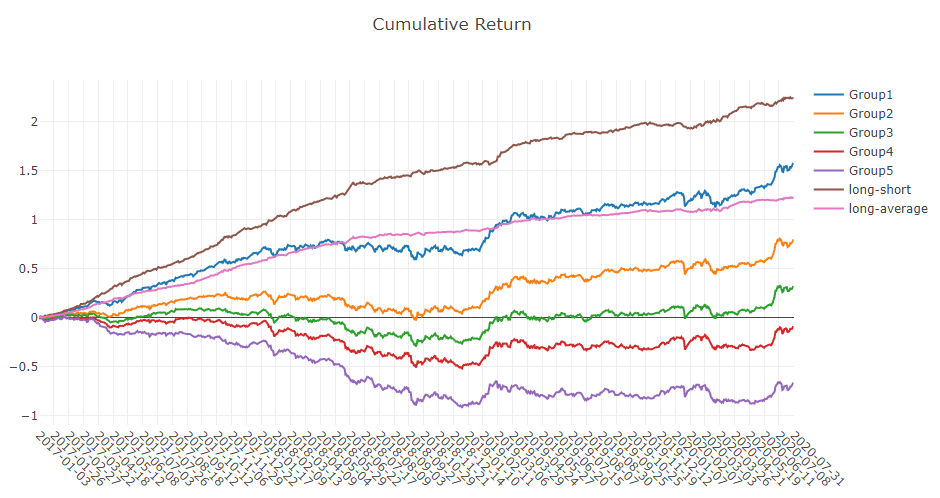
2. 그래프 보고서 분석: 먼저 `python -m pip install .[analysis]`로 필요한 의존성을 설치합니다. 그런 다음 `jupyter notebook`으로 `examples/workflow_by_code.ipynb`를 실행하면 그래프 보고서를 볼 수 있습니다.
- 예측 신호(모델 예측) 분석
- 그룹별 누적 수익률
- 수익률 분포
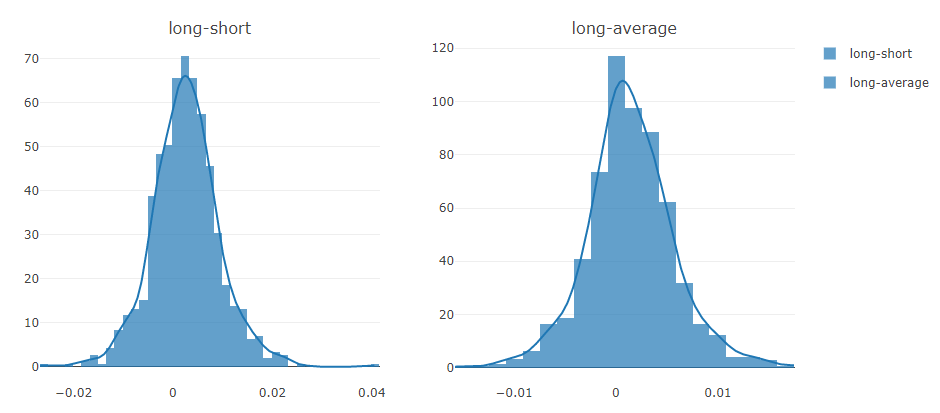
- 정보 계수(IC)
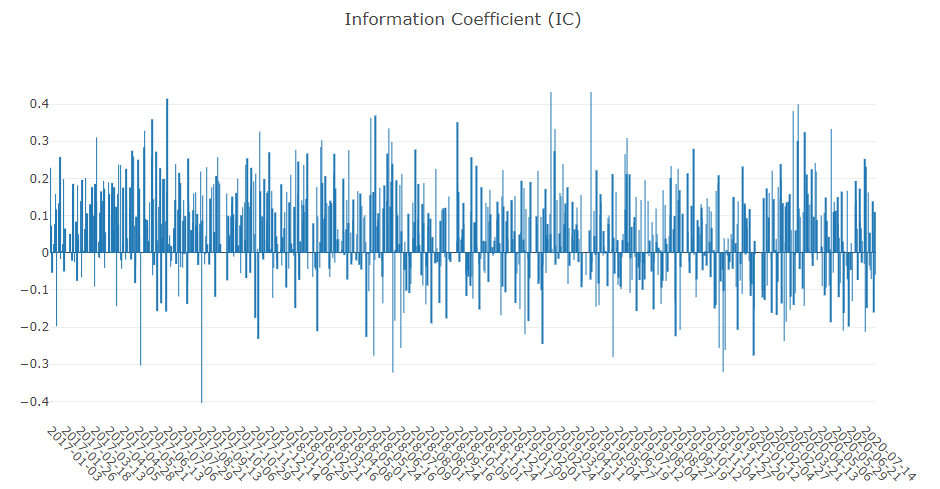
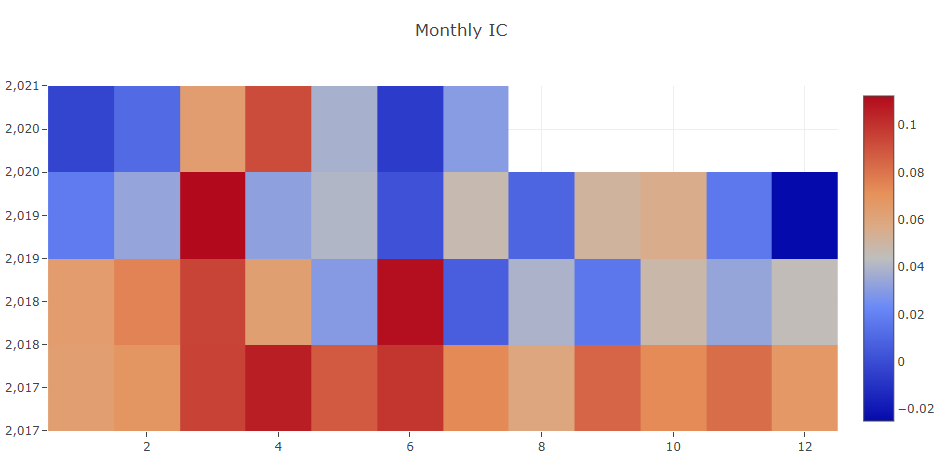
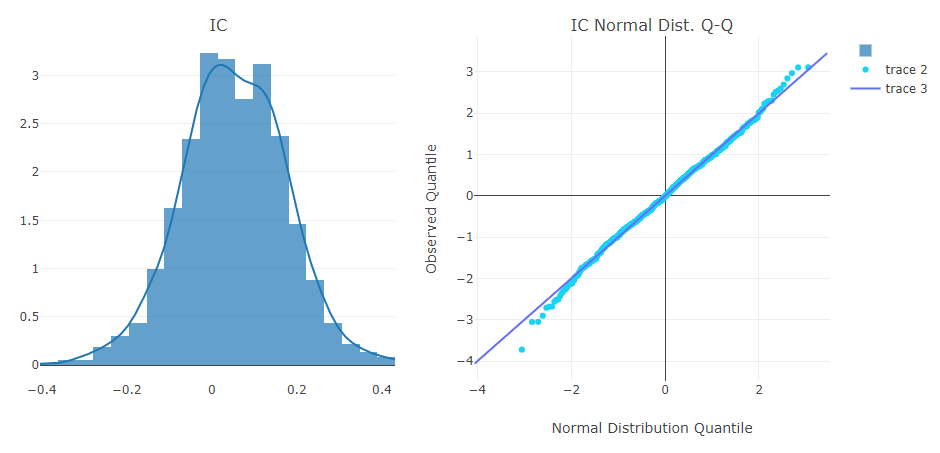
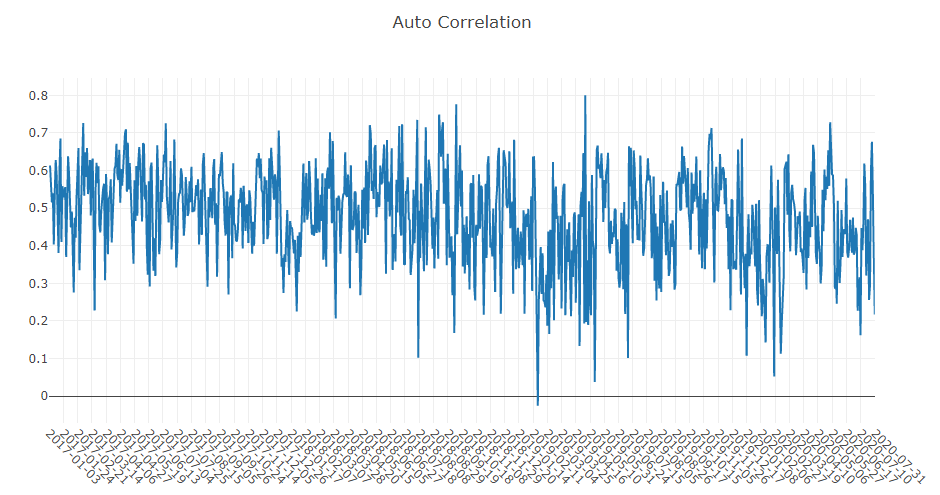
- 예측 신호(모델 예측)의 자기상관
- 포트폴리오 분석
- 백테스트 수익률
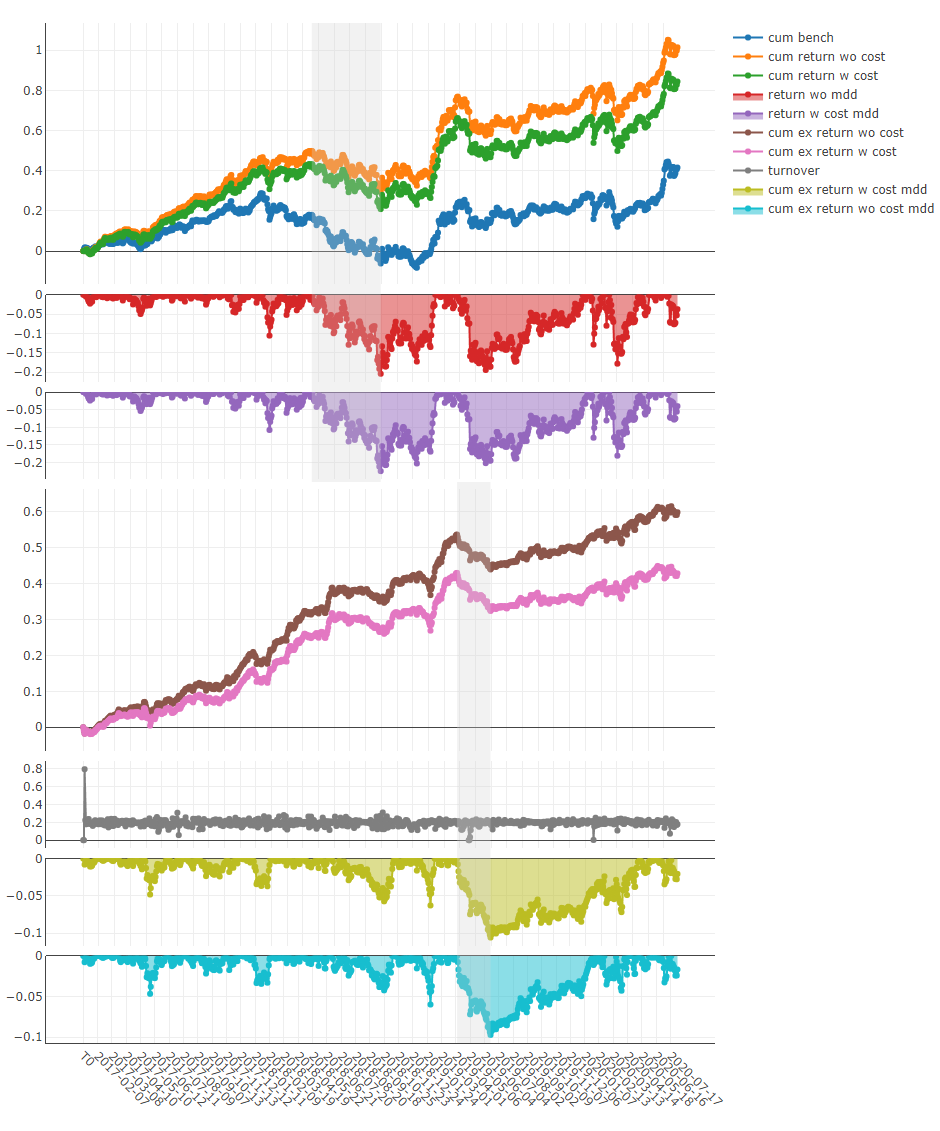
- 위 결과의 설명
## 코드로 맞춤 퀀트 연구 워크플로 만들기
자동 워크플로가 모든 퀀트 연구자의 연구 흐름에 맞지는 않을 수 있습니다. 유연한 퀀트 연구 워크플로를 지원하기 위해 Qlib은 연구자가 코드로 자기만의 워크플로를 만들 수 있는 모듈형 인터페이스도 제공합니다. 다음은 코드로 맞춤 퀀트 연구 워크플로를 만드는 데모입니다.
# 퀀트 연구의 주요 과제와 해법
퀀트 투자는 풀어야 할 핵심 과제가 많은 아주 독특한 환경입니다. 현재 Qlib은 그중 몇 가지에 대한 해법을 제공합니다.
## 예측: 가치 있는 신호와 패턴 찾기
주가 추세를 정확히 예측하는 것은 수익성 있는 포트폴리오를 구성하는 데 매우 중요한 부분입니다. 하지만 금융 시장에는 다양한 형식의 방대한 데이터가 있어 예측 모델을 만들기가 어렵습니다.
복잡한 금융 데이터에서 가치 있는 신호와 패턴을 찾는 예측 모델 구축에 초점을 맞춘 최신 퀀트 연구 성과와 논문이 `Qlib`에 계속 공개되고 있습니다.
### 퀀트 모델(논문) 동물원
`Qlib` 위에 만든 모델 목록입니다.
- XGBoost 기반 GBDT (Tianqi Chen 외, KDD 2016)
- LightGBM 기반 GBDT (Guolin Ke 외, NIPS 2017)
- Catboost 기반 GBDT (Liudmila Prokhorenkova 외, NIPS 2018)
- pytorch 기반 MLP
- pytorch 기반 LSTM (Sepp Hochreiter 외, Neural computation 1997)
- pytorch 기반 GRU (Kyunghyun Cho 외, 2014)
- pytorch 기반 ALSTM (Yao Qin 외, IJCAI 2017)
- pytorch 기반 GATs (Petar Velickovic 외, 2017)
- pytorch 기반 SFM (Liheng Zhang 외, KDD 2017)
- tensorflow 기반 TFT (Bryan Lim 외, International Journal of Forecasting 2019)
- pytorch 기반 TabNet (Sercan O. Arik 외, AAAI 2019)
- LightGBM 기반 DoubleEnsemble (Chuheng Zhang 외, ICDM 2020)
- pytorch 기반 TCTS (Xueqing Wu 외, ICML 2021)
- pytorch 기반 Transformer (Ashish Vaswani 외, NeurIPS 2017)
- pytorch 기반 Localformer (Juyong Jiang 외)
- pytorch 기반 TRA (Hengxu, Dong 외, KDD 2021)
- pytorch 기반 TCN (Shaojie Bai 외, 2018)
- pytorch 기반 ADARNN (YunTao Du 외, 2021)
- pytorch 기반 ADD (Hongshun Tang 외, 2020)
- pytorch 기반 IGMTF (Wentao Xu 외, 2021)
- pytorch 기반 HIST (Wentao Xu 외, 2021)
- pytorch 기반 KRNN
- pytorch 기반 Sandwich
새 퀀트 모델의 PR을 크게 환영합니다.
`Alpha158`과 `Alpha360` 데이터셋에서 각 모델의 성능은 벤치마크 문서에서 볼 수 있습니다.
### 모델 하나 실행하기
위에 나열한 모든 모델은 `Qlib`으로 실행할 수 있습니다. benchmarks 폴더에서 제공하는 설정 파일과 모델에 대한 자세한 내용을 볼 수 있습니다.
`Qlib`은 모델 하나를 실행하는 세 가지 방법을 제공하며, 상황에 맞는 것을 고르면 됩니다.
- 위에서 말한 `qrun` 도구로 설정 파일 기반의 모델 워크플로를 실행합니다.
- `examples` 폴더에 있는 것을 바탕으로 `workflow_by_code` 파이썬 스크립트를 만듭니다.
- `examples` 폴더의 `run_all_model.py` 스크립트로 모델을 실행합니다. 구체적인 셸 명령 예시는 `python run_all_model.py run --models=lightgbm`이며, `--models` 인수에는 위에 나열한 모델을 얼마든지 줄 수 있습니다(쓸 수 있는 모델은 benchmarks에서 확인). 더 많은 사용 예는 파일의 docstring을 보세요.
- **참고**: 기준선마다 환경 의존성이 다르므로 파이썬 버전이 요건과 맞는지 확인하세요(예: TFT는 `tensorflow==1.15.0` 제약으로 Python 3.6~3.7만 지원).
### 모델 여러 개 실행하기
`Qlib`은 여러 모델을 여러 번 반복해 실행하는 `run_all_model.py` 스크립트도 제공합니다(**참고**: 이 스크립트는 지금은 *Linux*만 지원합니다. 다른 OS는 앞으로 지원할 예정입니다. 또한 같은 모델을 여러 번 병렬로 실행하는 것도 지원하지 않으며, 이것도 앞으로 고칠 예정입니다).
스크립트는 모델마다 고유한 가상환경을 만들고 학습이 끝나면 환경을 지웁니다. 그래서 `IC`와 `backtest` 결과 같은 실험 결과만 생성되어 저장됩니다.
모든 모델을 10번 반복해 실행하는 예시입니다.
```python
python run_all_model.py run 10
특정 모델을 한꺼번에 실행하는 API도 있습니다. 더 많은 사용 예는 파일의 docstring을 보세요.
호환성 깨짐
pandas에서 group_key는 groupby 메서드의 매개변수 중 하나입니다. pandas 1.5에서 2.0으로 가면서 group_key의 기본값이 기본값 없음에서 True로 바뀌어 qlib 실행 중 오류가 납니다. 그래서 group_key=False로 설정했지만, 다음을 포함한 일부 프로그램이 올바로 돌아간다는 보장은 없습니다.
- qlib\examples\rl_order_execution\scripts\gen_training_orders.py
- qlib\examples\benchmarks\TRA\src\dataset.MTSDatasetH.py
- qlib\examples\benchmarks\TFT\tft.py
시장 동역학에 적응하기
금융 시장 환경은 비정상(non-stationary)이라 기간에 따라 데이터 분포가 바뀔 수 있고, 그러면 학습 데이터로 만든 모델의 성능이 미래 시험 데이터에서 떨어집니다. 그래서 예측 모델과 전략을 시장 동역학에 맞추는 것이 모델과 전략의 성능에 매우 중요합니다.
Qlib 위에 만든 해법 목록입니다.
- 롤링 재학습
- pytorch 기반 DDG-DA (Wendi 외, AAAI 2022)
강화학습: 연속적인 결정 모델링
Qlib은 이제 연속적인 투자 결정을 모델링하도록 설계된 강화학습을 지원합니다. 이 기능은 환경과의 상호작용에서 배우며 누적 보상을 최대로 만드는 방식으로 투자자가 매매 전략을 최적화하도록 돕습니다.
시나리오별로 분류한 Qlib 위의 해법 목록입니다.
주문 집행을 위한 강화학습
이 시나리오의 소개가 있습니다. 아래 방법은 모두 여기서 비교합니다.
- TWAP
- PPO: "An End-to-End Optimal Trade Execution Framework based on Proximal Policy Optimization", IJCAL 2020
- OPDS: "Universal Trading for Order Execution with Oracle Policy Distillation", AAAI 2021
퀀트 데이터셋 동물원
퀀트에서 데이터셋은 매우 중요한 역할을 합니다. Qlib 위에 만든 데이터셋 목록입니다.
| 데이터셋 | 미국 시장 | 중국 시장 |
|---|---|---|
| Alpha360 | √ | √ |
| Alpha158 | √ | √ |
Qlib으로 데이터셋을 만드는 튜토리얼이 있습니다. 새 퀀트 데이터셋을 만드는 PR을 크게 환영합니다.
학습 프레임워크
Qlib은 맞춤 설정이 잘 되고 구성 요소의 상당수를 학습시킬 수 있습니다. 학습 가능한 구성 요소는 예측 모델과 트레이딩 에이전트의 인스턴스입니다. 이들은 학습 프레임워크 계층에서 학습된 뒤 워크플로 계층의 여러 시나리오에 적용됩니다. 학습 프레임워크는 워크플로 계층도 활용합니다(예: 정보 추출기 공유, 집행 환경을 바탕으로 환경 만들기).
학습 패러다임에 따라 강화학습과 지도학습으로 나눌 수 있습니다.
- 지도학습의 자세한 문서는 여기서 볼 수 있습니다.
- 강화학습의 자세한 문서는 여기서 볼 수 있습니다. Qlib의 RL 학습 프레임워크는
워크플로계층의집행 환경으로 환경을 만듭니다.NestedExecutor도 지원한다는 점이 눈여겨볼 만합니다. 덕분에 서로 다른 수준의 전략/모델/에이전트를 함께 최적화할 수 있습니다(예: 특정 포트폴리오 관리 전략에 맞춘 주문 집행 전략 최적화).
Qlib 더 알아보기
qlib에서 가장 자주 쓰는 구성 요소를 한눈에 보려면 노트북을 시험해 보세요.
자세한 문서는 docs에 정리되어 있습니다. HTML 문서를 만들려면 Sphinx와 readthedocs 테마가 필요합니다.
cd docs/
conda install sphinx sphinx_rtd_theme -y
# Otherwise, you can install them with pip
# pip install sphinx sphinx_rtd_theme
make html
최신 문서를 온라인으로 바로 볼 수도 있습니다.
Qlib은 활발히 계속 개발 중입니다. 계획은 로드맵에 있으며 github 프로젝트로 관리합니다.
오프라인 모드와 온라인 모드
Qlib의 데이터 서버는 오프라인 모드나 온라인 모드로 배포할 수 있으며, 기본은 오프라인 모드입니다.
오프라인 모드에서는 데이터가 로컬에 배포됩니다.
온라인 모드에서는 데이터가 공유 데이터 서비스로 배포됩니다. 데이터와 캐시를 모든 클라이언트가 공유하므로 캐시 적중률이 높아져 데이터 조회 성능이 좋아지고 디스크도 덜 씁니다. 온라인 모드 문서는 Qlib-Server에 있습니다. 온라인 모드는 Azure CLI 기반 스크립트로 자동 배포할 수 있습니다. 온라인 데이터 서버의 소스 코드는 Qlib-Server 저장소에 있습니다.
Qlib 데이터 서버 성능
데이터 처리 성능은 AI 기술 같은 데이터 기반 방법에 중요합니다. AI 중심 플랫폼인 Qlib은 데이터 저장과 처리 솔루션을 제공합니다. Qlib 데이터 서버의 성능을 보이기 위해 여러 다른 데이터 저장 솔루션과 견주었습니다.
주식 시장의 기본 OHLCV 일 데이터(2007~2020년, 하루 800종목)로 데이터셋(특성/팩터 14개)을 만드는 같은 작업을 끝내는 시간으로 성능을 평가했습니다. 이 작업에는 데이터 조회와 처리가 들어갑니다.
| HDF5 | MySQL | MongoDB | InfluxDB | Qlib -E -D | Qlib +E -D | Qlib +E +D | |
|---|---|---|---|---|---|---|---|
| 합계 (1CPU) (초) | 184.4±3.7 | 365.3±7.5 | 253.6±6.7 | 368.2±3.6 | 147.0±8.8 | 47.6±1.0 | 7.4±0.3 |
| 합계 (64CPU) (초) | 8.8±0.6 | 4.2±0.2 |
+(-)E는ExpressionCache를 쓴(안 쓴) 경우+(-)D는DatasetCache를 쓴(안 쓴) 경우
대부분의 범용 데이터베이스는 데이터를 불러오는 데 시간이 너무 오래 걸립니다. 내부 구현을 살펴보니 범용 데이터베이스 솔루션에서는 데이터가 너무 많은 인터페이스 계층과 불필요한 형식 변환을 거칩니다. 이런 오버헤드가 데이터 불러오기를 크게 늦춥니다. Qlib 데이터는 과학 계산용 배열로 합치기 효율적인 압축 형식으로 저장됩니다.
관련 보고서
- Guide To Qlib: Microsoft’s AI Investment Platform
- 微软也搞AI量化平台?还是开源的!
- 微矿Qlib:业内首个AI量化投资开源平台
문의
- 문제가 있으면 이슈를 만들거나 gitter에 메시지를 보내세요.
Qlib에 기여하려면 풀 리퀘스트를 만들어 주세요.- 그 밖의 이유로는 이메일(qlib@microsoft.com)로 문의해 주세요.
- 새 멤버(정규직과 인턴 모두)를 모집하고 있으며 이력서를 환영합니다!
IM 토론 그룹에 참여하세요.
| Gitter |
|---|
 |
기여
모든 기여에 감사드립니다!
2020년 9월 GitHub에 오픈소스로 공개하기 전까지 Qlib은 팀 내부 프로젝트였습니다. 안타깝게도 내부 커밋 기록은 남아 있지 않습니다. 팀의 여러 구성원도 Qlib에 많은 기여를 했으며 Ruihua Wang, Yinda Zhang, Haisu Yu, Shuyu Wang, Bochen Pang, Dong Zhou가 포함됩니다. 특히 Qlib의 초기 버전을 만든 Dong Zhou에게 감사드립니다.
더 알아보기
기여 안내(풀 리퀘스트를 올릴 때의 코드 표준과 개발 안내), 마이크로소프트 오픈소스 행동 강령, 라이선스는 저장소 README 끝부분에 있습니다.
⚠️ 투자 안내 이 소개는 오픈소스 도구를 알리기 위한 글이며 투자 권유가 아닙니다. 이 도구가 내놓은 결과를 따른 매매의 손실 책임은 사용자에게 있습니다.
저장소: microsoft/qlib · 라이선스: MIT
평점
- 5점
- 0
- 4점
- 0
- 3점
- 0
- 2점
- 0
- 1점
- 0